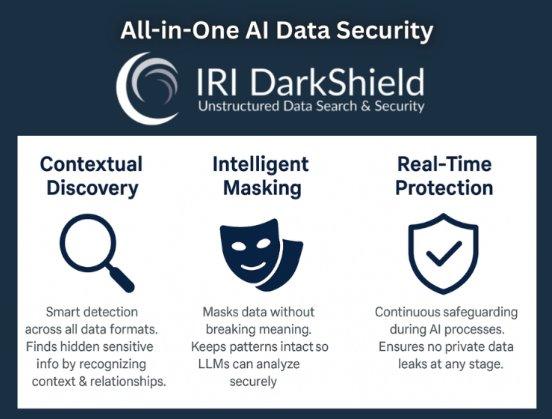
❌ DSGVO-konforme KI ❌ Personenbezogene Daten für KI-Modelle und LLMs sicher maskieren ❗
Künstliche Intelligenz und Large Language Models (LLMs) benötigen große und aussagekräftige Datenmengen. Doch Unternehmensdaten enthalten häufig personenbezogene Informationen wie Namen, Adressen, Kontaktdaten, Kontonummern, Gesundheitsinformationen oder andere sensible Inhalte. Werden solche Daten ungeprüft für KI-Training, Retrieval-Augmented Generation (RAG), Tests oder Analysen verwendet, können erhebliche Datenschutz- und Compliance-Risiken entstehen.
Datenmaskierung schafft die technische Grundlage, um sensible Informationen zu schützen und Daten gleichzeitig für KI-Anwendungen nutzbar zu halten. Personenbezogene Daten werden dabei erkannt, klassifiziert und durch geeignete Verfahren geschützt, bevor sie an ein KI-Modell, eine Analyseplattform oder einen externen Dienst übergeben werden.
Warum müssen personenbezogene Daten vor der KI-Nutzung geschützt werden?
KI-Systeme verarbeiten Informationen aus Datenbanken, Dokumenten, E-Mails, PDF-Dateien, Bildern, Cloud-Speichern und zahlreichen weiteren Quellen. Gerade in unstrukturierten Datenbeständen können personenbezogene Informationen unbemerkt enthalten sein.
Ein wirksames Datenschutzkonzept sollte deshalb bereits vor dem Training oder der Verarbeitung durch ein KI-System ansetzen. Sensible Daten werden zunächst automatisiert gesucht und klassifiziert. Anschließend können sie entsprechend festgelegter Datenschutzregeln maskiert, pseudonymisiert, verschlüsselt, ersetzt oder entfernt werden.
So lässt sich das Risiko reduzieren, dass personenbezogene Informationen in Trainingsdaten, Prompts, Vektordatenbanken, Modellergebnissen oder Testumgebungen offengelegt werden.
Welche Verfahren schützen Daten für KI und LLMs?
Je nach Datenart, Verwendungszweck und Schutzbedarf kommen unterschiedliche Methoden infrage:
- Pseudonymisierung: Direkte Identifikatoren werden durch konsistente Ersatzwerte ersetzt. Zusammengehörige Datensätze und Beziehungen können erhalten bleiben.
- Tokenisierung: Sensible Originalwerte werden gegen kontrollierte Token ausgetauscht.
- Formaterhaltende Verschlüsselung (FPE): Werte werden geschützt, behalten jedoch ihr ursprüngliches Format und können deshalb in bestehenden Anwendungen weiterverarbeitet werden.
- Redaktion und Anonymisierung: Personenbezogene Inhalte werden vollständig entfernt oder so verändert, dass eine Identifizierung verhindert werden soll.
- Synthetische Daten: Künstlich erzeugte Datensätze bilden benötigte Strukturen, Regeln und Verteilungen ab, ohne reale personenbezogene Ausgangsdaten direkt zu verwenden.
Pseudonymisierte Daten gelten allerdings grundsätzlich weiterhin als personenbezogene Daten. Ob eine Verarbeitung die Anforderungen der DSGVO erfüllt, hängt deshalb auch vom konkreten Anwendungsfall, den technischen und organisatorischen Maßnahmen sowie der möglichen Reidentifizierung ab.
IRI DarkShield erkennt und maskiert sensible KI-Daten!
Mit IRI DarkShield lassen sich personenbezogene und andere sensible Informationen in strukturierten, semistrukturierten und unstrukturierten Datenbeständen suchen, klassifizieren und maskieren. Dazu gehören unter anderem:
- Text-, PDF- und Microsoft-Office-Dokumente
- JSON-, XML-, EDI- und Parquet-Dateien
- relationale Datenbanken und NoSQL-Datenbanken
- Bilder und medizinische Dokumente
- lokale Speicherorte und Cloud-Umgebungen
Suchregeln, reguläre Ausdrücke, Wörterbücher und Machine-Learning-Verfahren helfen dabei, relevante PII- und PHI-Daten zu identifizieren. Die gefundenen Informationen können anschließend regelbasiert de-identifiziert werden. Dadurch eignet sich DarkShield besonders für Datenbestände, die für generative KI, RAG-Systeme, LLMs oder andere Machine-Learning-Anwendungen vorbereitet werden sollen.
Synthetische Daten für datenschutzgerechtes KI-Training!
Wenn reale Produktionsdaten nicht verwendet werden sollen, bietet IRI RowGen eine zusätzliche Möglichkeit: die Erzeugung synthetischer Test- und Trainingsdaten.
Dabei können Datenformate, Wertebereiche, Abhängigkeiten, Verteilungen und referenzielle Beziehungen gezielt nachgebildet werden. Unternehmen erhalten realistische Datensätze für Entwicklung, Qualitätssicherung, Analysen und KI-Projekte, ohne sensible Originalinformationen direkt bereitzustellen.
Datenmaskierung und synthetische Datengenerierung lassen sich außerdem kombinieren. So können geeignete Teile vorhandener Daten geschützt übernommen und fehlende oder besonders kritische Informationen synthetisch ergänzt werden.
Bleibt die Datenqualität für KI-Modelle erhalten?
Geeignete Maskierungsverfahren schützen personenbezogene Merkmale, während relevante Strukturen, Formate und statistische Eigenschaften weitgehend erhalten bleiben können. Welche Methode optimal ist, hängt vom Trainingsziel und von den benötigten Datenbeziehungen ab.
Daher sollte nach jeder Maskierung oder Datensynthese geprüft werden, ob die Daten weiterhin repräsentativ sind und das gewünschte KI-Modell zuverlässige Ergebnisse liefert. Datenschutz und Datenqualität müssen gemeinsam betrachtet werden.
Datenschutzgerechte KI als kontrollierter Prozess!
Eine sichere KI-Strategie beginnt nicht erst beim Modell, sondern bereits bei der Auswahl und Vorbereitung der Daten. Ein kontrollierter Prozess umfasst:
- Datenquellen identifizieren
- Personenbezogene und sensible Daten erkennen
- Informationen klassifizieren
- Geeignete Schutzverfahren anwenden
- Ergebnisse dokumentieren und überprüfen
- Nur freigegebene Daten an KI-Systeme übergeben
Mit IRI DarkShield für die Suche und Maskierung sensibler Informationen sowie IRI RowGen für die Erzeugung synthetischer Daten können Unternehmen Datenschutz frühzeitig in ihre KI-Prozesse integrieren. Dies verbessert die Kontrolle, Nachvollziehbarkeit und Auditierbarkeit und unterstützt einen verantwortungsvollen Einsatz von KI.
Effizienz trifft Erfahrung: Seit mehr als vier Jahrzehnten unterstützen unsere Softwarelösungen Unternehmen bei Datenmanagement und Datenschutz – technologisch führend, zuverlässig im produktiven Einsatz und branchenübergreifend einsetzbar.
Seit 1978 im Einsatz: Zahlreiche namhafte Unternehmen, Dienstleister, Finanzinstitute sowie Landes- und Bundesbehörden zählen zu unseren langjährigen Kunden – nationale Referenzen sind hier gelistet und internationale Referenzen sind hier zusammengefasst.
Maximale Kompatibilität: Unsere Software unterstützt sowohl klassische Mainframe-Plattformen (Fujitsu BS2000/OSD, IBM z/OS, z/VSE, z/Linux) als auch moderne Open-System-Umgebungen wie Linux, UNIX-Derivate und Windows.
Sparen Sie Zeit und Geld bei der Manipulation oder dem Schutz Ihrer Daten mit unserer bewährten Low-Code-Datenmanagement- und Maskierungssoftware. Wir verbinden modernste Technologie mit jahrzehntelanger Erfahrung in der Verarbeitung von Produktionsdaten auf verschiedenen Plattformen und in unterschiedlichen Branchen.
Mit unserer Software können Sie:
Große Sortier- und ETL-Aufträge beschleunigen
Beschleunigung von Datenbank-Entladungen, -Ladungen, -Reorgs und -Abfragen
Konvertieren und Neuformatieren von alten Datentypen, Dateien und Datenbanken
Erstellung benutzerdefinierter Berichte oder Aufbereitung von Daten für Analysen und KI
Ersetzen von alten ETL-, SQL- und Sortieraufträgen
Suchen, Extrahieren und Restrukturieren unstrukturierter Daten
Replizieren und Erfassen geänderter Datenbank-Daten in Echtzeit
Filtern, Bereinigen, Anreichern und Standardisieren von Daten
PII klassifizieren, entdecken und de-identifizieren
Daten statisch, dynamisch oder inkrementell maskieren
PHI-Re-ID-Risiko bewerten und Quasi-Identifikatoren anonymisieren
Synthetisieren von strukturell und referenziell korrekten Testdaten
Profitieren Sie von der Leistungsfähigkeit und Flexibilität der preisgekrönten IRI-Lösungen, die von Analysten beraten und durch 40 Partnerbüros weltweit unterstützt werden. Vermeiden Sie die steile Lernkurve und die hohen Kosten von Multi-Tool- und Mega-Anbieter-Lösungen und entdecken Sie die Vorteile schnellerer Design- und Laufzeiten für Ihr Unternehmen.
Die spezifischen Lösungen sind kompatibel mit allen gängigen Betriebssystemen, vom Mainframe (Fujitsu BS2000/OSD, IBM z/OS und z/VSE + z/Linux) bis hin zu Open Systems (UNIX & Derivate, Linux + Windows).
Seit 1978 weltweit anerkannt im B2B-Sektor: Großunternehmen, nationale und internationale Dienstleister, Privat-, Groß-, Landes- und Bundesbanken, Sozial- und Privatversicherungen sowie deutsche, Landes- und Bundesbehörden!
JET-Software
Edmund-Lang-Straße 16
64832 Babenhausen
Telefon: +49 (6073) 711-403
Telefax: +49 (6073) 711-405
https://www.jet-software.com
Telefon: +49 (6073) 711403
Fax: +49 (6073) 711405
E-Mail: amadeus.thomas@jet-software.com
