Probiert aus, macht Fehler – darin findet ihr immer Perlen
Das war die Kernbotschaft meines Vortrags *„The Response is Now – WebSockets with TYPO3 Restrictions"*. Und ich meine das wörtlich: Die eigentliche Geschichte dahinter ist keine glatte Erfolgsstory, sondern eine über vier Jahre und mehrere Anläufe, von denen die meisten erst einmal scheiterten. Der entscheidende Punkt dabei: Die finale Lösung ist kein Neuanfang, sondern baut direkt auf dem allerersten Versuch auf und erweitert ihn – ohne diesen ersten, noch unfertigen Wurf wäre sie nie entstanden. In diesem Artikel erzähle ich, wie das gelaufen ist – und warum ich glaube, dass sich das Ausprobieren und Scheitern immer lohnt.
Das Problem: Polling ist Verschwendung
Der Ausgangspunkt war simpel und dürfte vielen bekannt vorkommen: Ein Frontend soll sofort reagieren, wenn sich im Backend etwas ändert – neue Nachricht, neuer Task, neues Event. Die naheliegende Lösung ist Polling: Der Browser fragt in regelmäßigen Abständen beim Server nach, ob es etwas Neues gibt, der Server antwortet, das Frontend reagiert. Funktioniert, ist aber ineffizient – gerade in einer TYPO3/PHP-Umgebung, wo jede Anfrage einen vollen Request-Response-Zyklus bedeutet, egal ob es tatsächlich etwas Neues gibt oder nicht.
WebSockets lösen das grundsätzlich anders: Statt immer wieder neu zu fragen, hält der Browser eine dauerhafte, bidirektionale Verbindung zum Server. Daten können übertragen werden, sobald sie anfallen – in beide Richtungen, ohne dass jemand fragen muss. Die Idee ist alt und die Technik ausgereift. Das Problem war nie das Konzept, sondern die Frage: Wie bekommt man das sauber mit TYPO3 und PHP zusammen?
Perle 1: Der PoC von 2021
Meine erste Antwort auf diese Frage war ein Proof of Concept aus dem Jahr 2021 – und ehrlich gesagt keine besonders schöne. Die Implementierung des WebSocket-Gateways war, um es milde auszudrücken, unschön: Für jeden Server-zu-Server-Aufruf brauchte es eine eigene Route, und das Ganze konnte im Kern nur eine einzige Client-Verbindung gleichzeitig verwalten – nie mehr als eine wurde tatsächlich gespeichert. Für ein System, das mehrere gleichzeitig verbundene Nutzer bedienen soll, ist das offensichtlich unbrauchbar. Der Kunde zeigte damals wenig Interesse an dem Konzept, und das Projekt verschwand erst einmal in der Schublade – aber eben nicht für immer, wie sich später zeigen sollte.
Die Perle daraus: Ein PoC muss nicht schön sein, er muss nur zeigen, wo die eigentlichen Probleme liegen und ob das Grundprinzip trägt. Genau dieses Grundprinzip – ein Gateway, das Verbindungen entgegennimmt und Events verteilt – war hier schon richtig erkannt. Was fehlte, war eine Architektur, die von Grund auf mit mehreren Verbindungen umgehen kann.
Perle 2: ReactPHP und die Grenzen der Hilfsmittel
Erst 2025, mehrere Jahre später, griff ich das Thema wieder auf. Der nächste Anlauf setzte auf ReactPHP. Auf dem Papier eine naheliegende Wahl für asynchrones PHP. In der Praxis funktionierten die WebSocket-Funktionen nicht wie erwartet, und das Routing für POST-Aufrufe wollte einfach nicht laufen. An dieser Stelle habe ich auch KI-Unterstützung zurate gezogen – mit gemischtem Ergebnis:
Der Assistent erfand munter Methoden, die es in der Bibliothek schlicht nicht gab.
Eine gute Erinnerung daran, dass man jede vorgeschlagene Lösung selbst verifizieren muss, so überzeugend sie auch klingt.
Die Perle daraus: Nicht jedes Werkzeug, das auf dem Papier passt, passt auch in der Praxis zum eigenen Stack – und weder eine Bibliothek noch ein Sprachmodell ersetzen das eigene Nachprüfen.
Perle 3: RatchetPHP und der Proxy-Konflikt
RatchetPHP war der nächste Versuch – mit saubereren Interfaces und deutlich besserer Dokumentation als ReactPHP. Diesmal lag das Problem woanders, und zwar an einer Stelle, die ich vorher nicht auf dem Schirm hatte: Ein zweiter PHP-Server ließ sich nicht ohne Konflikte gemeinsam mit React über nginx proxien.
Die Architektur war technisch stimmig, scheiterte aber am Deployment-Setup drumherum.
Die Perle daraus: Manchmal liegt das eigentliche Hindernis nicht im Code, sondern in der Infrastruktur, die man um den Code herum baut. Das gehört genauso zur Lösung wie die Kernlogik selbst.
Die Lösung: NestJS – und das Kobayashi-Maru-Prinzip
Am Ende war es dann kein PHP-Framework, das die Aufgabe gelöst hat, sondern NestJS. Und hier schließt sich der Kreis zum PoC von 2021:
Die finale Architektur ist im Kern genau dessen Gateway-Idee, nur diesmal richtig zu Ende gedacht. Die Storage-Klasse, die jetzt beliebig viele Client-Verbindungen verwaltet, ist die direkte Antwort auf die eine große Schwäche des Ur-PoC, der nie mehr als eine Verbindung speichern konnte.
Ohne den ersten, holprigen Versuch hätte ich vermutlich gar nicht gewusst, worauf es bei dieser Storage-Klasse wirklich ankommt – das Problem war ja schon vier Jahre vorher exakt benannt worden, nur eben noch nicht gelöst.
Die finale Architektur besteht aus drei Bausteinen: dem erwähnten, jetzt sauber gelösten WebSocket-Gateway als Interface zu den Standardbibliotheken, einer Controller-Struktur mit einer Methode pro Route – bewusst angelehnt an die Art, wie man APIs in TYPO3 aufbaut – und eben jener Storage-Klasse für die aktiven Client-Verbindungen. Wer aus der Extbase-Welt kommt, findet sich in dieser Struktur schnell zurecht, auch wenn die Sprache eine andere ist.
Genau das bringt mich zum Kern des Vortrags, den ich als eine Art Kobayashi-Maru-Prinzip bezeichnet habe – eine kleine Star-Trek-Anspielung, die ich kurz erklären will, falls sie nicht jedem geläufig ist. Der Kobayashi Maru ist in Star Trek eine Prüfungssimulation der Sternenflotten-Akademie: ein Szenario, das eigentlich unlösbar ist – jede Entscheidung führt zur Niederlage. Die bekannteste Figur, die den Test trotzdem „gewonnen" hat, ist James T. Kirk. Sein Trick dabei ist der entscheidende Punkt: Er hat nicht in der Prüfungssituation selbst improvisiert und gehofft, dass es schon klappen wird. Er hat vorher, in Ruhe, die Simulation umprogrammiert – und wusste dadurch bereits vor dem eigentlichen Test, dass sein Vorgehen funktioniert.
Genau darin liegt für mich die Parallele, und das ist auch der Kernsatz, den ich aus dem Vortrag mitgeben wollte:
Eine Lösung ist dann die beste, wenn man vorher schon weiß, dass sie funktioniert.
Bei Kirk war das die vorherige Programmierarbeit, bei uns war es der PoC. Der PoC von 2021 war zwar für sich genommen nicht einsatzfähig, aber er hat vorab bewiesen, dass das Grundprinzip – ein Gateway, das Verbindungen entgegennimmt und Events verteilt – tatsächlich funktioniert. Als ich 2025 bei NestJS ankam, war das deshalb kein Sprung ins Ungewisse mehr, sondern die Umsetzung von etwas, von dem ich durch den PoC schon wusste, dass es trägt. Daher das Fazit, das ich dem Vortrag gegeben habe:
"The best solution is the one you know that already works."
Nicht die theoretisch eleganteste Lösung gewinnt, sondern die, von der man aus eigener Erfahrung – und sei es aus einem holprigen Vorläufer – bereits weiß, dass sie funktioniert.
Sicherheit darf dabei nicht hinten runterfallen
Ein System, das Server-zu-Server- und Server-zu-Client-Kommunikation offenlegt, braucht klare Grenzen. Die Server-zu-Server-Kommunikation läuft über einen gemeinsamen X-Websocket-Token im HTTP-Header, zusätzlich wird die IP-Adresse gegen den TYPO3-Server abgeglichen. Auf der Client-Seite gilt ein einfaches, aber wichtiges Prinzip: Der Client bekommt nie Rohdaten direkt über den WebSocket geliefert, sondern ausschließlich Benachrichtigungen darüber, dass es etwas Neues gibt. Die eigentlichen Inhalte lädt er anschließend ganz regulär über die UID nach – und durchläuft dabei die bestehenden ACL-Prüfungen von TYPO3. Fehlt die Berechtigung, gibt es einen 403, wie überall sonst auch.
Ein typischer Ablauf sieht dann so aus:
„`
// Client → Server (Login/Identität) {"event":"identity", "data":{"access":[1,2], "user":2, "company":3}}
// Server → Server (neuer Task) {"type":"task", "access":"2", "company":"3", "uid":"6"}
// Server → Client (Benachrichtigung, keine Daten) {"action":"newEvent", "type":"task", "uid":6} „`
Die eigentliche Zugriffskontrolle bleibt damit vollständig dort, wo sie hingehört: in TYPO3.
Fazit
Vier Anläufe über vier Jahre, drei davon gescheitert – und trotzdem war jeder einzelne notwendig, um am Ende bei einer Lösung zu landen, die tatsächlich trägt. Der PoC von 2021 legte das Fundament und benannte das eigentliche Problem, auch wenn er es selbst noch nicht lösen konnte. ReactPHP zeigte die Grenzen blinden Vertrauens in Bibliotheken und KI-Vorschläge, RatchetPHP zeigte, dass Infrastruktur genauso zählt wie Code.
Die finale NestJS-Lösung ist am Ende keine davon losgelöst entstanden, sondern eine direkte Weiterentwicklung jenes ersten, unfertigen PoC – ohne ihn gäbe es sie so nicht. Deshalb bleibe ich bei meinem Fazit aus dem Vortrag:
Probiert aus. Macht Fehler. Darin könnt ihr immer Perlen finden. Die beste Lösung ist am Ende oft nicht die theoretisch schönste, sondern die, die man durch genau diesen Prozess wirklich verstanden hat.
punkt.de GmbH
Sophienstr. 187
76185 Karlsruhe
Telefon: +49 (721) 9109-0
Telefax: +49 (721) 9109-100
https://www.punkt.de
Geschäftsführer
Telefon: +49 (721) 9109-124
E-Mail: stein@punkt.de

30 Jahre punkt.de
30 Jahre punkt.de – Beständigkeit braucht Veränderung
30 Jahre sind für ein IT-Unternehmen eine bemerkenswerte Zeit. Man könnte jetzt erzählen, welche Programmiersprachen, Content-Management-Systeme und Infrastrukturkonzepte in diesen drei Jahrzehnten gekommen und wieder verschwunden sind. Man könnte Jahreszahlen, Projekte und Meilensteine aneinanderreihen.
Das wäre vermutlich vollständig. Aber es würde wenig darüber erzählen, warum es punkt.de heute noch gibt.
Denn ein Unternehmen bleibt nicht 30 Jahre relevant, indem es möglichst lange am Bestehenden festhält. Gerade in unserer Branche wäre das eine ziemlich schlechte Strategie.
Beständigkeit entsteht, wenn ein Unternehmen weiß, was es verändern muss – und was nicht.
Bei punkt.de haben sich Technologien, Leistungen und Organisationsstrukturen immer wieder grundlegend verändert. Geblieben sind der Blick auf die Probleme unserer Kund:innen, unser technischer Anspruch und die Überzeugung, dass gute Dienstleistungen nur in einem guten Team entstehen können.
Die Technik verändert sich. Das Problem des Kunden bleibt.
punkt.de begann 1996 mit klassischen Internetleitungen. Aus dieser Zeit stammt eine Geschichte, die viel darüber erzählt, wie wir bis heute arbeiten.
Der damalige IT-Leiter von HEINE bestellte bei uns zunächst privat eine Internetleitung. Wir wunderten uns durchaus darüber, warum eine Privatperson eine solche Leitung benötigte. Wir lieferten trotzdem den Service, den wir für richtig hielten. Ein Jahr später kam er mit HEINE als Unternehmen zu uns. Daraus entstand eine Zusammenarbeit, die fast 20 Jahre hielt.
Natürlich lässt sich eine solche Geschichte nicht einfach auf die Gegenwart übertragen. Unsere Projekte sind größer geworden, die Technologien komplexer und die Anforderungen geschäftskritischer. Trotzdem steckt darin ein Prinzip, das bis heute gilt: Wir interessieren uns nicht nur für einen Auftrag. Wir wollen verstehen, welches Problem dahinterliegt.
Bei der Deutschen Post führte das einmal so weit, dass wir bei uns eine virtuelle Postfiliale aufgebaut haben. Wir wollten die Abläufe nicht nur technisch abbilden, sondern wirklich verstehen und testen können. Heute erlebe ich etwas Ähnliches, wenn ich gemeinsam mit unserem Team bei FEGIME sitze. Manchmal verstehe ich nur die Hälfte des Gesprächs – weil sich unser Team und die Ansprechpartner:innen auf Kundenseite so tief in die fachlichen Prozesse eingearbeitet haben.
Ich halte das für eine Stärke. Gute Dienstleistung bedeutet nicht, auf jede Frage sofort eine fertige Antwort zu haben. Sie bedeutet, sich so intensiv mit einer Herausforderung zu beschäftigen, dass aus einem fremden Problem ein gemeinsames wird.
Nicht die Ersten. Aber zur richtigen Zeit dabei.
Unser technischer Fokus hat sich in 30 Jahren mehrfach verschoben: von Internetleitungen über Websites mit TYPO3, Hosting und Serverbetrieb bis zu E-Commerce, Automatisierung, digitalen Geschäftsprozessen und KI.
Dabei waren wir selten die Allerschnellsten. Dafür sind unsere Projekte zu groß, unsere Verantwortung zu hoch und wir vermutlich auch nicht „wild“ genug. Wir springen nicht auf jede neue Technologie, nur weil sie gerade Aufmerksamkeit bekommt.
Wir können es uns aber ebenso wenig leisten, Entwicklungen zu verschlafen.
Im E-Commerce sind wir vergleichsweise spät tief eingestiegen. Bei KI waren wir ebenfalls nicht die Ersten, haben die Technologie inzwischen aber bereits weit in unsere Prozesse integriert.
Der richtige Zeitpunkt liegt für uns meistens zwischen zwei Extremen: nicht beim ersten Hype, aber deutlich vor dem Moment, an dem Veränderung nur noch unter Druck möglich ist.
Diese Balance wird schwieriger. Wir müssen uns heute schneller in neue Technologien einarbeiten und vielseitiger werden. Kund:innen können nicht monatelang warten, bis wir ein relevantes System von Grund auf kennengelernt haben.
Das heißt aber nicht, dass punkt.de zur Full-Service-Agentur für alles wird. Wir werden weiterhin kein Marketing, Design oder UX aus eigener Hand anbieten. Unser Feld ist die technische Open-Source-Digitalisierung: CMS, E-Commerce, Automatisierung mit Werkzeugen wie n8n und CIB seven, Identity-Management mit Keycloak, Suchlösungen mit Elasticsearch – und in den kommenden Jahren vermutlich noch einiges mehr.
Dafür brauchen wir Spezialist:innen, die für ihre Themen brennen. Vielseitigkeit entsteht nicht dadurch, dass alle alles ein bisschen können. Sie entsteht durch ein Team mit unterschiedlichen Schwerpunkten, das sein Wissen miteinander teilt und den Markt aufmerksam beobachtet.
Unabhängigkeit heißt nicht, alles selbst zu betreiben
Eine technische Entscheidung aus dem Jahr 2003 prägt uns bis heute.
Damals ging der Anbieter eines proprietären CMS insolvent, das punkt.de eingesetzt hatte. Unser Gründer Jürgen Egeling schlug vor, künftig auf TYPO3 zu setzen. Seine Begründung war ebenso einfach wie vorausschauend: Wenn dieses System irgendwann nicht mehr weiterentwickelt wird, können wir es aufgrund des offenen Quellcodes notfalls selbst retten.
Wir haben diese Entscheidung nie bereut.
Open Source und Unabhängigkeit gehören seitdem fest zu punkt.de. Was Unabhängigkeit konkret bedeutet, diskutieren wir allerdings immer wieder neu. Die Antwort von 2003 reicht für eine Welt aus Cloud-Plattformen, Software-as-a-Service und proprietären KI-Modellen nicht mehr aus.
Für uns bedeutet digitale Souveränität deshalb bewusste Entscheidungen statt Dogma. Auch wir nutzen derzeit beispielsweise Microsoft 365. Entscheidend ist nicht, jede Abhängigkeit grundsätzlich zu vermeiden. Das wäre in vielen Fällen weder realistisch noch wirtschaftlich sinnvoll.
Entscheidend ist, die eigene Abhängigkeit zu kennen.
Für Microsoft 365 haben wir eine klare Exit-Strategie erarbeitet. Ein Wechsel wäre nicht schmerzfrei und nicht reibungslos. Aber wir wissen, wie wir vorgehen könnten, wenn er notwendig wird. Dieses Prinzip übertragen wir auch auf unsere Kundenprojekte: Neue Kund:innen erhalten von Beginn an eine Exit-Strategie.
Niemand sollte mit uns zusammenarbeiten müssen, weil technische oder organisatorische Umstände einen Wechsel praktisch unmöglich machen. Wir wollen, dass Kund:innen bei uns bleiben, weil die Zusammenarbeit funktioniert.
Das ist für mich gelebte Unabhängigkeit.
Wir haben nicht nur Technologien ausgetauscht
Der größere Teil unserer Veränderung war von außen vermutlich kaum sichtbar. Denn wir haben nicht nur unser Leistungsportfolio weiterentwickelt, sondern auch die Art, wie wir das Unternehmen organisieren.
Als ich 2010 als dualer Student zu punkt.de kam, wollte ich zunächst Integrator werden. Relativ schnell stellte ich fest, dass das nicht mein Weg war, und wechselte noch während des Studiums in den Vertrieb. 2013 übernahm ich die Verantwortung für Vertrieb und Marketing, arbeitete später drei Jahre als Product Owner eines Entwicklungsteams und stieg 2019 in die Geschäftsführung ein.
Dass dieser Weg möglich war, sagt viel über punkt.de aus.
Menschen kommen nicht als fertige Stellenbeschreibung zu uns. Interessen verändern sich, Fähigkeiten entwickeln sich und Verantwortung kann wachsen.
Auch das Unternehmen selbst hat verschiedene Organisationsmodelle durchlaufen. Wir kamen aus einem klassischen Projektmanagement, führten 2012 feste Teams und Product Owner ein und entwickelten im Rahmen von „Reinventing punkt.de“ unsere Organisation grundlegend weiter. Später übernahm eine PO-Runde einen Teil der Unternehmensführung. Darauf folgte das punkt.de-Impuls-Gremium. Inzwischen befinden wir uns im Generationswechsel mit einer neuen Geschäftsführung; Jürgen zog sich 2023 aus der Geschäftsführung zurück und unterstützt uns heute noch in technischen Fragen.
Nicht jeder dieser Schritte war auf Anhieb richtig. Wir sind dabei auch in Richtungen gelaufen, die wir später korrigieren mussten. Das gehört zur Wahrheit eines Unternehmens, das sich über einen so langen Zeitraum weiterentwickelt.
Worauf ich stolz bin: Diese Veränderungen haben uns nicht zerrissen.
Sie haben Diskussionen ausgelöst und Kraft gekostet. Gerade Jürgen und ich hatten häufig unterschiedliche Vorstellungen – besonders, als ich noch relativ jung die Verantwortung für den Vertrieb übernahm. Aber diese Auseinandersetzungen haben uns weitergebracht. Nicht, weil am Ende immer einer recht hatte, sondern weil unterschiedliche Perspektiven bei punkt.de ausgehalten werden konnten.
Heute unterstützen verschiedene Austausch- und Entscheidungsgremien diese Zusammenarbeit. In der Docu Crew sitzt beispielsweise eine Person aus jedem Team. Dort entstehen firmenweite Standards – von Coding Guidelines bis zu Richtlinien für mobiles Arbeiten. In „Dev Meets Ops“ werden übergreifende Infrastrukturfragen geklärt und zentrale Komponenten direkt umgesetzt.
Gute Zusammenarbeit entsteht nicht allein durch ein Leitbild. Sie braucht Räume, Verantwortlichkeiten und funktionierende Strukturen.
Wachsen, ohne alles selbst werden zu müssen
In den vergangenen Jahren haben wir mehrfach darüber nachgedacht, schneller zu wachsen, mehr Themen abzudecken und am Markt sichtbarer zu werden. Wir hätten versuchen können, Design, UX und Marketing selbst aufzubauen und jede benötigte Kompetenz unter einem Dach zu versammeln.
Wir haben uns bewusst anders entschieden.
punkt.de ist im besten Sinne eine Nerdbude. Wir haben einen hohen Anspruch an unsere technische Arbeit und wollen diesen Schwerpunkt nicht verwässern. Eine klassische Full-Service-Agentur muss zwangsläufig andere Kompromisse eingehen. Das ist nicht schlechter – es ist ein anderes Modell.
Komplementäre Kompetenzen binden wir deshalb über langfristige Partnerschaften ein. Mit sulit.digital verbinden wir Design und technologische Umsetzung, ohne so zu tun, als hätten wir selbst für jede Disziplin die besten Antworten. Über 1_FORGE können wir große TYPO3-Projekte gemeinsam auf Augenhöhe umsetzen.
Um dieselbe Größe und Kompetenzbreite vollständig selbst aufzubauen, müssten wir erheblich wachsen. Dabei würden wir vermutlich Teile unserer Kultur verlieren, die punkt.de heute ausmachen.
Unsere Partnerschaften geben uns deshalb das Beste aus zwei Welten: die Fähigkeiten und Kapazitäten größerer Strukturen, ohne unsere eigene Identität aufzugeben.
Die nächsten Jahre werden uns erneut verändern
Ein Jubiläum lädt dazu ein, vor allem zurückzuschauen. Im Moment beschäftigt uns allerdings stärker, was vor uns liegt.
Die wirtschaftliche Entwicklung der vergangenen Jahre trifft auf einen technologischen Umbruch durch KI. Beides zwingt uns, schneller zu reagieren. Unsere Arbeitsweisen werden sich verändern, ebenso unsere Leistungen und vermutlich auch unser Pricing.
Die klassische Abrechnung nach Stunden kommt an Grenzen, wenn mehrere KI-Agenten parallel an unterschiedlichen Aufgaben arbeiten. Wie ein faires und tragfähiges Modell künftig genau aussieht, wissen wir noch nicht. So ehrlich müssen wir sein.
Auch die Rollen unserer Kolleg:innen verändern sich. Der Anteil klassischer Codearbeit wird voraussichtlich sinken. Dafür werden Überblick, fachliches Verständnis, Systemdenken und die Fähigkeit, Ergebnisse kritisch zu prüfen, wichtiger. Diesen Wandel gemeinsam zu gestalten, ist eine der größten Aufgaben der kommenden fünf Jahre.
In verschiedenen KI-Runden diskutieren wir deshalb Richtlinien und Prozesse. Dabei suchen wir bewusst den Mittelweg zwischen Begeisterung und Skepsis. Wir wollen Möglichkeiten nutzen, ohne jedes Problem reflexartig mit KI zu bearbeiten.
Vor allem glauben wir nicht an die einfache Erzählung, man könne die Hälfte eines Teams entlassen und das anschließend als erfolgreiche KI-Transformation verkaufen. punkt.de soll auch in diesem Wandel ein stabiler und verlässlicher Arbeitgeber bleiben. Das heißt nicht, dass jede Tätigkeit unverändert bleibt. Es heißt, dass wir Verantwortung für die Veränderung übernehmen und die Menschen dabei nicht aus dem Blick verlieren.
Parallel arbeiten wir an unserer ISO-27001-Zertifizierung. Auch das ist kein isoliertes Sicherheitsprojekt, sondern eine Folge unserer Entwicklung. Wir kommen zunehmend von klassischen Marketinglösungen zu Open-Source-Digitalisierung in geschäftskritischen Prozessen. Je relevanter unsere Anwendungen für das operative Geschäft werden und je sensibler die verarbeiteten Daten sind, desto systematischer müssen wir Informationssicherheit organisieren.
Mehr Verantwortung braucht klarere Strukturen.Gekommen, um uns weiterzuentwickeln
30 Jahre punkt.de bedeuten nicht, dass wir 30 Jahre lang alles richtig gemacht haben. Wir haben Fehler gemacht, Entwicklungen zu spät erkannt und Wege eingeschlagen, die wir später korrigieren mussten.
Aber wir haben uns immer wieder verändert, ohne das Unternehmen dabei zu verlieren.
Technologien werden kommen und gehen. Unsere Organisationsstruktur wird in zehn Jahren vermutlich wieder anders aussehen. KI wird Rollen verändern, neue Leistungen ermöglichen und uns vor Entscheidungen stellen, deren Antworten wir heute noch nicht kennen.
Bleiben sollen etwas anderes: unsere Nähe zu den Problemen unserer Kund:innen, unser technischer Anspruch, unsere Freude an Open Source und ein menschlicher Umgang miteinander.
Wir sind nicht immer die Schnellsten. Wir sind nicht in jeder Disziplin die Besten. Und wir haben nicht auf jede Frage sofort eine Antwort.
Aber wir bemühen uns seit 30 Jahren darum, das Richtige zu tun – fachlich, wirtschaftlich und menschlich. Offenbar nicht ganz ohne Erfolg.
punkt.de GmbH
Sophienstr. 187
76185 Karlsruhe
Telefon: +49 (721) 9109-0
Telefax: +49 (721) 9109-100
https://www.punkt.de
Geschäftsführer
Telefon: +49 (721) 9109-124
E-Mail: stein@punkt.de

Der beste Livegang ist unspektakulär – wie wir Risiken durch Vorbereitung und kleine Schritte reduzieren
Artikel 3 von 4 aus der Serie „Arbeiten mit punkt.de“
Bei einem Livegang treffen wir uns meistens zu einem festgelegten Zeitpunkt in einem digitalen Raum. Der oder die Product Owner:in geht mit dem Team die Checkliste durch. Wir ändern Konfigurationen, schalten eine Domain um und beobachten das System.
Dann warten wir.
Manche Kund:innen sind überrascht, dass wir nicht aufgeregt durcheinanderlaufen. Für sie ist der Livegang der große Moment, auf den das Projekt lange hingearbeitet hat. Für uns sollte das, was technisch passiert, zu diesem Zeitpunkt schon ziemlich gewöhnlich sein.
Wir freuen uns trotzdem jedes Mal und im besten Fall ist die Livegang-Party auch schon geplant und Kuchen und Sekt stehen bereit.
Lieber früh live als lange fast fertig
Wir versuchen, einen ersten Livegang so früh wie sinnvoll anzusetzen. Diese Haltung ist bei punkt.de nicht neu: Bereits 2015 haben wir über die Vorteile eines Continuous Relaunchs geschrieben. Auch unser damaliger Beitrag in der Computerwoche stellte die Frage, warum der Big-Bang-Relaunch Geschichte sein sollte.
Der Gedanke dahinter ist einfach: Ein neues System muss nicht mit seinem vollständigen, für die nächsten Jahre geplanten Funktionsumfang starten. Es kann mit einem sinnvollen Kern live gehen, echtes Feedback sammeln und sich anschließend weiterentwickeln.
Technisch klingt das logisch. Im Unternehmen ist es oft schwierig.
Wenn ein altes System über Jahre gewachsen ist, besitzt fast jede Abteilung Funktionen, die sie schützen möchte. Mit weniger live zu gehen, fühlt sich dann wie ein Rückschritt an – selbst wenn die vorhandenen Funktionen deutlich besser funktionieren als vorher. Aus vielen nachvollziehbaren Einzelinteressen entsteht schnell wieder ein großer Gesamtumfang.
Wir beraten an dieser Stelle, zeigen Abhängigkeiten und schlagen Ausbaustufen vor. Die Entscheidung bleibt beim Kunden. Nach unserer Erfahrung hatten allerdings gerade diejenigen Kund:innen besonders gute Livegänge, die den Mut zu einem kleineren ersten Schritt aufgebracht haben.
Weniger Funktionen bedeuten nicht automatisch weniger Wert. Wenn die richtigen Funktionen besser sind, können sie früher Nutzen bringen.
Was am Livegang passieren muss, sollte vorher Routine sein
Ein früher Livegang darf kein leichtfertiger Livegang sein. Je kleiner wir den Schritt machen, desto zuverlässiger müssen die notwendigen Abläufe funktionieren.
Unser Ziel ist deshalb, möglichst viel von dem, was am Livegang-Tag passieren muss, in Code zu gießen. Datenmigrationen, Konfigurationen und Deployments sollen reproduzierbar sein. Automatisierte Tests und CI/CD-Prozesse helfen uns dabei, Änderungen kontinuierlich zu prüfen und auszuliefern. Warum das für uns mehr als ein Werkzeugthema ist, beschreiben wir ausführlicher in CI/CD als Kultur.
Ein besonders anschauliches Beispiel war der Relaunch eines Kundenportals mit mehr als 200.000 Angeboten. Diese Daten mussten zuverlässig in das neue System importiert werden. Ein halbes Jahr vor dem Livegang begannen wir deshalb, jede Nacht alle Angebote zu importieren.
Nacht für Nacht lief derselbe Prozess. Wir beobachteten ihn, fanden Engpässe und optimierten den Importer. Dadurch war die entscheidende Datenmigration am Livegang-Tag kein einmaliges Experiment mehr. Es lief einfach noch einmal der Importer – nur diesmal für das Produktivsystem.
Genau diese Art von Langeweile wollen wir beim Livegang erreichen.
Eine Checkliste macht aus vielen Gewerken einen Ablauf
Trotz Automatisierung bleibt ein Livegang eine gemeinsame organisatorische Aufgabe. Die Gesamtverantwortung liegt bei unserem oder unserer Product Owner:in. Dort laufen die einzelnen Aufgaben, Zuständigkeiten und Zeitpunkte zusammen.
Eine reale Checkliste für einen Website-Livegang enthielt beispielsweise:
- Redirects einpflegen,
- Inhalte und Termine in das Produktivsystem übertragen,
- Datenschutzerklärung und Impressum prüfen,
- Serverkonfiguration und Cronjobs umstellen,
- zu einem festgelegten Zeitpunkt die Domain umschalten,
- direkt danach Kontaktformular und Suche testen,
- den Suchindex neu aufbauen,
- den Eingang von Matomo-Daten prüfen,
- SEO, Performance, Web Vitals und Barrierefreiheit kontrollieren.
Die Liste zeigt, warum ein Livegang keine rein technische Angelegenheit ist. Infrastruktur und Anwendung gehören ebenso dazu wie Inhalte, Datenschutz, Analytics, Auffindbarkeit und Nutzererlebnis.
Der oder die Product Owner:in hält den Ablauf zusammen. Zu einem vereinbarten Zeitpunkt treffen sich die Beteiligten in einem digitalen Raum, arbeiten die relevanten Schritte ab und teilen ihren Status. Viele Handgriffe bestehen dann tatsächlich darin, vorbereitete Konfigurationen zu aktivieren – und anschließend aufmerksam zu beobachten.
Ruhe am Livegang-Tag ist kein Zeichen dafür, dass wenig passiert. Sie ist das Ergebnis erfolgreicher Arbeit im Vorfeld!
Nach dem Umschalten beginnt das echte Feedback
Auch ein gründlich getestetes System trifft erst nach dem Livegang auf seinen vollständigen Alltag. Dann arbeiten echte Nutzer:innen mit echten Daten, Gewohnheiten und Erwartungen. Dass dabei neue Themen sichtbar werden, ist normal.
Kritische technische Fehler sollten uns nicht zuerst von Nutzer:innen gemeldet werden. Dafür investieren wir in Testing und Monitoring. Wenn ein wichtiger Dienst ausfällt oder sich ein technisches Problem abzeichnet, soll unser Team es selbst erkennen und reagieren.
Bei Nutzerfeedback ist die Lage weniger eindeutig. In manchen Projekten bauen wir einen Feedback-Button ein, über den Rückmeldungen direkt bei uns landen. In anderen unterstützen wir die Ansprechpartner:innen des Kunden dabei, Hinweise aus verschiedenen Kanälen zu sammeln und zu strukturieren.
In den ersten Tagen und Wochen müssen der Kunde und unser Product Owner:in diese Rückmeldungen gemeinsam einordnen:
- Ist das ein Fehler, der schnell behoben werden muss?
- Ist die Bedienung tatsächlich unklar?
- Ist die Reaktion Teil der normalen Gewöhnung an ein neues System?
- Ist es eine gute Idee für eine spätere Ausbaustufe?
Nicht jede Irritation sollte sofort eine Änderung auslösen. Aber „Die Nutzer:innen müssen sich nur daran gewöhnen“ darf auch keine Ausrede sein, berechtigtes Feedback zu ignorieren. Diese Unterscheidung braucht Erfahrung, Gespräch und manchmal etwas Zeit.
Nach dem Projekt ist vor der dauerhaften Entwicklung
Nach der intensiveren Livegang-Phase geht das System in die dauerhafte Betreuung über. Diese besteht bei uns meist aus drei Bausteinen.
1. Wartung und Pflege
Wir halten Infrastruktur, Software und angebundene Systeme aktuell. Updates, Upgrades, Sicherheitsmaßnahmen und technisches Monitoring sorgen dafür, dass die Anwendung stabil und betreibbar bleibt.
2. Support und Hilfe
Wir unterstützen dort, wo das System im Alltag auf Menschen und Organisation trifft: beim Redaktionssupport, bei kleineren Bedienungsproblemen oder auch bei der technischen Begleitung einer Kampagne. Nicht jedes Anliegen ist ein Entwicklungsprojekt. Es braucht trotzdem jemanden, der das System kennt und helfen kann.
3. Weiterentwicklung
Größere Ausbaustufen planen und budgetieren wir häufig als eigene Vorhaben. Zusätzlich benötigt eine Anwendung ein gewisses Budgetgrundrauschen. Es ermöglicht dem Product Owner:in und den festen Ansprechpartner:innen, kleinere Verbesserungen umzusetzen, Feedback aufzunehmen und die Entwicklung des Systems im Blick zu behalten.
Keine Software, die man heutzutage baut, ist fertig.
Ohne dieses kontinuierliche Budget veraltet sie erstaunlich schnell. Oft bleiben schon kleine Verbesserungen im Ablauf liegen. Für sich genommen wirken sie vielleicht nicht kritisch. In der Summe werden sie zu täglicher Reibung. Die Zufriedenheit sinkt – bei den Nutzer:innen, beim Kunden und irgendwann auch im Projektteam.
Wer Weiterentwicklung lange genug aufschiebt, landet schließlich wieder bei einem großen Relaunch. Genau bei dem Zustand also, den ein Continuous Relaunch vermeiden soll.
Livegang ist ein Übergang, kein Endpunkt
Ein guter Livegang verbindet drei Dinge: eine bewusst begrenzte erste Version, technisch wiederholbare Abläufe und ein Team, das auch danach verantwortlich bleibt.
Manchmal gibt es vor dem Termin trotzdem stressige Phasen. Wir möchten das nicht romantisieren. Komplexe Systeme, viele Beteiligte und feste Termine lassen sich nicht immer vollständig entspannen. Aber Crunch-Time ist für uns kein Qualitätsmerkmal. Wenn am Livegang-Tag alle hektisch improvisieren müssen, ist vorher etwas schiefgelaufen.
Unser Ideal sieht anders aus: Wir schalten um, prüfen, beobachten – und freuen uns gemeinsam. Am nächsten Tag arbeiten wir weiter.
Weiterlesen: Im (noch unveröffentlichten) vierten Teil dieser Serie geht es um Projekte mit besonderen Rahmenbedingungen und darum, wie wir bei unseren Spezialistenprojekten unsere Kompetenzen, Partner und Erfahrungen zusammenbringen.
Vorher lesen: Im zweiten Teil dieser Serie ging es darum, wie die Zusammenarbeit im laufenden Projekt konkret aussieht: wie wir unsere Projektumgebung aufbauen, gemeinsam priorisieren, Aufgaben übergeben und für Budgettransparenz sorgen.
punkt.de GmbH
Sophienstr. 187
76185 Karlsruhe
Telefon: +49 (721) 9109-0
Telefax: +49 (721) 9109-100
https://www.punkt.de
Geschäftsführer
Telefon: +49 (721) 9109-124
E-Mail: stein@punkt.de

Keine Blackbox: Warum das Projekt unseren Kund:innen gehört
Artikel 2 von 4 aus der Serie „Arbeiten mit punkt.de“
Ich finde, eine faire Agenturbeziehung erkennt man an einer unangenehmen Frage: Was passiert, wenn der Kunde morgen sagt, dass er das Projekt beenden möchte?
Bei uns kann er alles mitnehmen, was bis dahin entstanden ist: Code, Tickets, Dokumentation, Entscheidungen und den aktuellen Arbeitsstand. Viele unserer Kund:innen haben deshalb nicht nur Zugriff auf Jira und Confluence, sondern auch direkt auf GitLab. Sie können verfolgen, wie sich der Code entwickelt – und sind nicht darauf angewiesen, dass wir ihnen den Stand des Projekts erklären.
Natürlich beginnen wir kein Projekt mit dem Ziel, es vorzeitig zu beenden. Viele unserer Kunden arbeiten über Jahre mit demselben punkt.de-Team zusammen. Aber genau diese Freiheit gehört für uns zu einer vertrauensvollen Partnerschaft: Das Projekt gehört dem Kunden, nicht der Agentur.
Im ersten Teil dieser Serie ging es darum, wie wir über den Punktlandungsworkshop und das Strategiepapier zu einem gemeinsamen Projektverständnis kommen. Jetzt wird daraus tägliche Zusammenarbeit.
Vom Strategiepapier zu einem steuerbaren Projekt
Nach der Beauftragung übersetzen unsere Product Owner:innen das Strategiepapier in zwei Strukturen: Epics für die inhaltliche Arbeit und Budgettöpfe für das Controlling.
Vorher findet ein interner Workshop mit dem zukünftigen Projektteam und den beteiligten Berater:innen statt. Dort werden nicht einfach Dokumente übergeben. Es geht um die Informationen zwischen den Zeilen:
- Welches Ziel ist für den Kunden entscheidend?
- Welches Feature muss besonders intelligent gelöst werden?
- Wo genügt ein pragmatischer erster Schritt?
- Wer entscheidet auf Kundenseite – und welche Vorgeschichte sollte das Team kennen?
Aus diesem Wissen schneiden der oder die Product Owner:in und das Team die ersten Epics und legen sie in Jira an. Der Kunde hat über den initialen Workshop bereits an ihrer Grundlage mitgearbeitet und sieht anschließend die konkrete Struktur. Korrekturen sind möglich, große Neuschnitte aber selten nötig.
Wir konzipieren zu diesem Zeitpunkt bewusst nicht jedes Detail bis zum Projektende. Die Epics geben Richtung und Zusammenhang. Die konkrete Ausarbeitung erfolgt dann, wenn ein Bereich tatsächlich näher an die Umsetzung rückt. So planen wir nicht monatelang an Erkenntnissen vorbei, die erst während der Arbeit entstehen.
Budgettöpfe sind ein Frühwarnsystem, kein Dogma
Auch Budgettransparenz braucht den richtigen Detailgrad. Ein einziger Topf für das Gesamtprojekt ist zu grob: Man erkennt erst spät, wo etwas aus dem Plan läuft. Dutzende kleine Positionen sind nicht automatisch besser. Im schlimmsten Fall verschwindet das eigentliche Problem in einer großen Datenmenge.
Deshalb teilen wir das angebotene Budget in wenige aussagekräftige Töpfe. Ab dem ersten Monat sieht der Kunde regelmäßig, wie viel in jedem Bereich vorgesehen und wie viel bereits verbraucht ist.
Diese Aufteilung ist ein Controlling-Instrument, kein Korsett. Läuft ein Topf schneller leer, betrachten wir zunächst die anderen. Vielleicht gleicht sich die Entwicklung im Gesamtprojekt aus. Wenn mehrere Töpfe deutlich schneller Budget verbrauchen, muss das Team reagieren. Dafür gibt es drei Stellschrauben:
- Wir verändern den Scope.
- Wir verbessern oder verändern Prozesse.
- Wir sprechen über zusätzliches Budget.
Keine davon ist automatisch angenehm. Aber alle drei sind besser, als eine Abweichung erst kurz vor Projektende zu entdecken.
Dieselben Tickets. Dieselbe Dokumentation. Derselbe Code.
Der Kunde erhält Zugriff auf das Jira-Board, auf dem auch wir arbeiten. Dort liegen operative und technische Tickets – nicht nur eine aufbereitete Auswahl für den nächsten Statusbericht.
Dasselbe gilt für Confluence: Protokolle, Entscheidungen und Dokumentation entstehen in einem gemeinsamen Projektraum. In vielen Projekten kommt GitLab hinzu. Der Kunde kann sehen, woran entwickelt wird, welche Änderungen in den Code einfließen und was bis zu diesem Zeitpunkt tatsächlich entstanden ist.
Niemand muss jedes Ticket lesen oder jeden Commit prüfen. Manche Kund:innen möchten tief einsteigen, andere konzentrieren sich auf fachliche Entscheidungen. Beides ist möglich. Der Grad der Mitarbeit ist verschiebbar, der Zugang zu den Informationen nicht.
Das hat einen sehr praktischen Effekt: Wenn Ansprechpartner:innen wechseln, Wissen übergeben werden muss oder die Zusammenarbeit endet, fängt der Kunde nicht bei null an. Der Projektstand steckt nicht nur in den Köpfen unserer Entwickler:innen und auch nicht in einem internen System, das wir allein kontrollieren.
Für uns ist das gelebte digitale Souveränität: nicht als abstraktes Versprechen, sondern als konkrete Möglichkeit, informiert zu entscheiden und handlungsfähig zu bleiben.
Ein Projektmanifest macht Prioritäten entscheidbar
Tickets sagen, was zu tun ist. Sie beantworten aber nicht automatisch, woran sich eine gute Entscheidung orientiert. Deshalb entwickeln wir mit dem Projektteam möglichst früh ein Projektmanifest.
Darin halten wir wenige Leitsätze fest, die die gemeinsame Richtung beschreiben. Bei einer späteren Entscheidung können wir fragen: Passt sie zu unserem Manifest?
Wenn nicht, gibt es zwei legitime Möglichkeiten. Wir verändern die Entscheidung. Oder wir passen das Manifest an, weil sich die Rahmenbedingungen oder unsere Erkenntnisse verändert haben. Wichtig ist, dass der Widerspruch sichtbar wird und die Kursänderung bewusst erfolgt.
Unsere Kolleg:innen von made in zeigen ausführlich, wie ein Projektmanifest gemeinsam entwickelt wird. Für uns ist es kein feierliches Dokument für die Ablage. Es ist eine Abkürzung für die schwierigen Diskussionen im Projektalltag.
Zusammenarbeit hat einen Rhythmus
Ein gemeinsames Board allein schafft noch keine gute Kommunikation. Ab Projektbeginn sprechen wir deshalb mindestens alle zwei Wochen in einem Jour fixe mit dem Kunden. In großen Projekten wird die Zusammenarbeit enger: Dann nehmen Kund:innen auch an Scrum-Events teil, in intensiven Phasen teilweise sogar an Dailys.
Dazwischen nutzen wir, was für die Situation sinnvoll ist. Kurze Rückfragen laufen häufig per Chat zwischen Product Owner:in und Kunde. Konkrete Aufgaben gehören ins Ticket. Komplexe oder dringende Fragen klären wir am Telefon oder im Videocall.
Entscheidend ist nicht, jeden Austausch in einen Prozess zu zwingen. Entscheidend ist, dass Fragen schnell bei den richtigen Menschen landen und relevante Ergebnisse anschließend für das Team nachvollziehbar sind.
Funktion für Funktion statt Überraschung am Ende
Neue Funktionalitäten übergeben wir einzeln auf einem Staging-System und bitten den Kunden um Abnahme. Vor dem ersten Livegang existiert meist zunächst nur diese geschützte Umgebung; später stehen Staging und Produktivsystem nebeneinander.
Die einzelne Abnahme verkürzt die Feedbackschleife. Wenn eine Funktion anders verstanden wurde oder sich in der Benutzung nicht richtig anfühlt, merken wir das früh. Wir entwickeln nicht über Monate ein großes Bündel und stellen dann fest, dass wir gemeinsam in die falsche Richtung gelaufen sind.
Das erfordert Mitarbeit auf Kundenseite. Nicht jede technische Entscheidung muss dort getroffen werden. Aber fachliches Feedback können wir nicht durch Agenturwissen ersetzen.
Probleme gehören auf den Tisch
Auch mit Budgettöpfen, Jour fixes und kurzen Abnahmeschleifen läuft ein komplexes Projekt nicht immer wie geplant. Der Unterschied ist: Abweichungen entstehen normalerweise nicht über Nacht. Beide Seiten können sehen, wie sie sich entwickeln.
Das operative Team versucht zunächst, gemeinsam nachzusteuern. Reicht diese Ebene nicht aus, gibt es in vielen Projekten ein Steering Board. Dann schauen wir mit der Managementseite des Kunden auf die Situation und entscheiden über Scope, Prozesse, Zusammenarbeit oder Budget.
Manchmal komme auch ich als zusätzliche Eskalationsstufe dazu. Nicht, um die Verantwortung des Teams zu übernehmen, sondern um eine festgefahrene Situation aus einer anderen Perspektive zu betrachten und gemeinsam mit dem Kundenmanagement wieder entscheidungsfähig zu werden.
Das gehört für mich zu dem Anspruch, den wir in unserem Loveletter formulieren: erfrischend direkt, ehrlich und bodenständig. Ehrlichkeit beweist sich nicht, solange alles grün ist. Sondern dann, wenn man eine schwierige Entwicklung früh anspricht.
Freiheit schafft Vertrauen
Unsere Kund:innen sollen wissen, woran wir arbeiten, wie sich das Budget entwickelt und welche Entscheidungen anstehen. Sie sollen sich beteiligen können, ohne jedes technische Detail selbst steuern zu müssen. Und sie sollen jederzeit auf das zugreifen können, was in ihrem Auftrag entstanden ist.
Das klingt zunächst wie eine Absicherung für das Ende einer Zusammenarbeit. In der Praxis ist es für uns eine Grundlage für lange Partnerschaften. Wer bleiben muss, weil Wissen, Code oder Dokumentation bei einer Agentur eingeschlossen sind, vertraut ihr nicht. Wer jederzeit gehen könnte und trotzdem bleibt, schon eher.
Im dritten Teil dieser Serie geht es um den Weg zum Livegang – und darum, warum ein Launch für uns kein einzelner großer Moment sein muss.
punkt.de GmbH
Sophienstr. 187
76185 Karlsruhe
Telefon: +49 (721) 9109-0
Telefax: +49 (721) 9109-100
https://www.punkt.de
Geschäftsführer
Telefon: +49 (721) 9109-124
E-Mail: stein@punkt.de

Ein gutes Angebot beginnt mit Verstehen – wie Projekte bei punkt.de starten
Wann beginnt ein Softwareprojekt? Mit dem unterschriebenen Angebot? Beim Kick-off? Oder mit dem ersten Ticket?
Für uns beginnt es früher: in dem Moment, in dem wir versuchen, die Herausforderung hinter einer Anfrage wirklich zu verstehen.
Wer bei uns anfragt, hat intern meistens längst entschieden, dass etwas passieren muss: Eine neue Website wird gebraucht, ein Extranet soll abgelöst oder eine individuelle Anwendung entwickelt werden. Manche Teams denken darüber erst seit wenigen Wochen nach, andere begleitet das Thema seit Jahren.
Was viele von ihnen zunächst gemeinsam haben:
Sie möchten ein Angebot. Eine Zahl. Möglichst schnell.
Das ist verständlich. Budgets müssen geplant und Anbieter verglichen werden. Trotzdem geben wir nur selten direkt ein Angebot für das eigentliche Projekt ab. Denn eine schnelle Zahl wäre zu diesem Zeitpunkt häufig vor allem eines: geraten.
Die eigentliche Herausforderung steht selten vollständig in der Anfrage
„Wir benötigen ein neues Extranet“ klingt zunächst eindeutig. Doch welche Aufgabe erfüllt das bestehende System? Wer arbeitet damit? Welche Funktionen sind unverzichtbar – und welche gibt es nur noch, weil es sie schon immer gab? Welche Prozesse und Schnittstellen hängen daran? Woran erkennen die Beteiligten später, dass das Projekt erfolgreich war?
Schon im ersten Termin stoßen wir meistens auf zwei oder drei Fragen, die sich nicht mal eben beantworten lassen. Das ist kein schlechtes Zeichen. Es zeigt, dass wir an den entscheidenden Stellen angekommen sind.
Natürlich könnten wir trotzdem einen Preis aus Annahmen ableiten. Wenn diese Annahmen nicht gemeinsam überprüft wurden, verlagert man die Unsicherheit jedoch nur in das Projekt. Später wird dann über Erwartungen, Verantwortlichkeiten und Nachträge diskutiert.
Das halten wir nicht für sinnvoll.
Unser Punktlandungsworkshop: erst den Kopf aufmachen, dann konkret werden
Um diese Unsicherheit früh zu bearbeiten, haben wir vor mehr als zehn Jahren ein Format entwickelt, das wir seitdem kontinuierlich weiterentwickeln: unseren Punktlandungsworkshop.
Der Name beschreibt den Ablauf ziemlich gut. Zunächst gewinnen wir Höhe und erweitern den Blick. Danach setzen wir zur Landung an.
Begleitet wird er in der Regel von unseren Berater:innen – häufig von Marco oder mir. Je nach Thema kommen Product Owner:innen, Designer:innen oder UX-Strateg:innen hinzu. Kein Workshop ist exakt wie der andere.
Der Vormittag gehört dem Verstehen. Wir lernen das Unternehmen, seine Ziele und die Geschichte des Projekts kennen. Wir betrachten Zielgruppen, Prozesse, technische Rahmenbedingungen und mögliche Entwicklungen. Dabei fragen wir auch nach Dingen, die zunächst außerhalb des geplanten Projekts liegen. Nicht, um es größer zu machen, sondern um wichtige Zusammenhänge nicht zu übersehen.
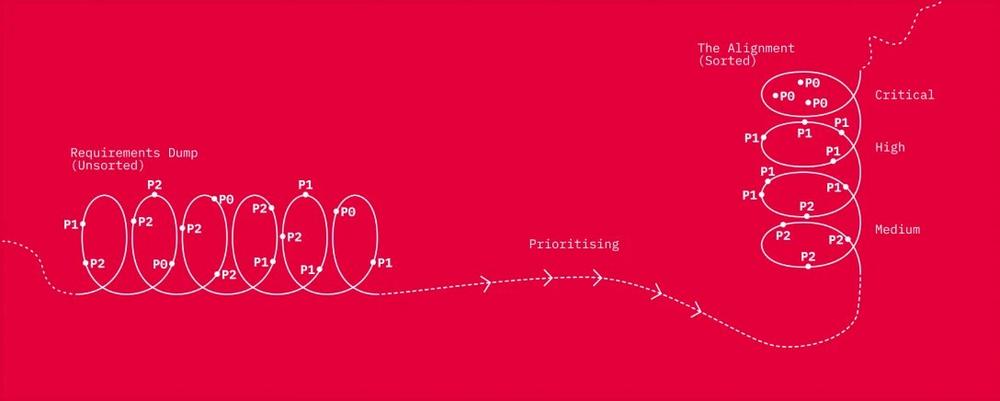
Am Nachmittag verdichten wir die Ergebnisse: Wir sortieren Funktionen, besprechen Ausbaustufen und setzen erste Prioritäten. Was gehört in eine erste Version? Was kann später folgen? Wo brauchen wir noch Konzeption?
Wenn die Aufgabe kleiner ist als gedacht und nach vier Stunden Klarheit besteht, sind wir früher fertig. Bei einem über Jahre gewachsenen System benötigen wir vielleicht länger.
Entscheidend ist nicht die Dauer. Entscheidend ist, dass beide Seiten anschließend dasselbe Projekt vor Augen haben.
Ein Strategiepapier statt eines isolierten Preisblatts
Nach dem Workshop erstellt die verantwortliche Person gemeinsam mit einem passenden Scrum-Team das Strategiepapier. Wir verlassen uns hier nicht auf KI sondern prüfen die Erkenntnisse durch Menschen, die das Projekt später umsetzen könnten.
Das Strategiepapier verbindet typischerweise vier Bereiche:
- kommunikative Herausforderungen und passende Lösungsansätze
- operative Herausforderungen und passende Lösungsansätze
- einen Vorschlag für den Projektplan
- einen Budgetvorschlag beziehungsweise das konkrete Angebot
Das Angebot ist also kein separates Preisschild, sondern Teil einer nachvollziehbaren Empfehlung. Dieses Papier präsentieren wir und entwickeln es mit dem Kunden weiter. Meist empfehlen wir eine klare Route. Grundlegend unterschiedliche Varianten zeigen wir nur, wenn sie für die Entscheidung wirklich relevant sind.
Auch darin zeigt sich unsere spätere Arbeitsweise: Wir verschwinden nicht mit den Anforderungen und kommen mit einem unveränderlichen Ergebnis zurück. Wir machen unseren Vorschlag sichtbar, holen Rückmeldung ein und schärfen ihn gemeinsam.
FEGIME: Ein gewachsenes Extranet wirklich verstehen
Wie tief wir dabei in die Welt eines Kunden eintauchen, zeigt unsere Zusammenarbeit mit der FEGIME Deutschland. Ihr individuell entwickeltes Extranet war über 15 Jahre gewachsen. Einige Funktionen wurden nicht mehr benötigt, andere waren für die Marktgemeinschaft unverzichtbar. Das System bildete nicht nur Technik ab, sondern auch Abläufe, Wissen und zahlreiche frühere Entscheidungen.
In einem zweitägigen Workshop haben wir das Vorhaben gemeinsam mit dem langjährigen IT-Ansprechpartner auseinandergenommen. Sein tiefes Wissen über Organisation, Nutzer:innen und Prozesse traf auf unsere Außenperspektive und Erfahrung mit komplexen Digitalprojekten. So konnten wir entscheiden, was bewahrt, entfernt oder neu gedacht werden sollte.
Das ist für uns Einarbeitung: nicht nur eine Funktionsliste aufnehmen, sondern das Unternehmen hinter dem System kennenlernen. Wie daraus ein MVP und ein schrittweiser Continuous Relaunch entstanden, zeigt unsere Case Study zum FEGIME-Extranet.
Wenn aus einem Vorschlag gemeinsame Verantwortung wird
Nimmt ein Kunde unseren Vorschlag an, passiert etwas, das ich gern ein Stück punkt.de-Magie nenne: Ein Team übernimmt Verantwortung für den Kunden – häufig über viele Jahre.
Das Wissen aus Kennenlernen, Workshop, Strategiepapier und Angebot fließt über standardisierte interne Prozesse in dieses Team. Der oder die Product Owner:in wird meist zur ersten operativen Ansprechperson. Aber der PO ist keine Trennwand zur Entwicklung. Wir planen bewusst ein Kennenlernen zwischen den Ansprechpartner:innen auf Kundenseite und den Entwickler:innen ein – meist remote, beim Kick-off je nach Projekt auch vor Ort.
Gemeinsam klären wir dann, was bereits zu Projektbeginn strategisch ausgearbeitet werden muss und welche Konzepte erst sinnvoll sind, wenn ihre Umsetzung ansteht. Unser Ziel: genug Klarheit für die Richtung und genug Beweglichkeit für das, was wir unterwegs lernen.
Zusammenarbeit lässt sich nicht vollständig abgeben
Unser Vorgehen hat eine Voraussetzung: Der Kunde muss Lust auf das Projekt und auf echte Zusammenarbeit haben.
Wir können viel abnehmen. Wie tief ein Kunde fachlich oder technisch mitdenkt, lässt sich je nach Projekt und Kapazität gestalten. Ein Modell funktioniert jedoch nicht: uns eine PDF zu übergeben und ein Jahr später eine fertige Lösung abzuholen.
Wir brauchen Wissen aus dem Unternehmen, Entscheidungen und iteratives Feedback. Kund:innen müssen dafür nicht jede technische Frage beantworten. Aber beide Seiten müssen Verantwortung für das Ergebnis übernehmen. Diese Erwartung sprechen wir lieber früh aus.
„Die verstehen, was wir sagen“
Viele vergleichbare Agenturen bringen die notwendigen technischen Fähigkeiten mit. Die Entscheidung fällt deshalb selten allein anhand einer Programmiersprache, eines CMS oder einer Featureliste. Sie fällt auch nach dem Gefühl, das in den ersten Gesprächen entsteht.
Das schönste Feedback, das wir nach einem Punktlandungsworkshop oder der Präsentation eines Strategiepapiers bekommen können, lautet sinngemäß: „Die verstehen, was wir sagen.“
Genau darum geht es uns. Wir möchten nicht nur Anforderungen protokollieren, sondern verstehen, warum sie existieren und wie sie zusammenhängen. Erst dann können wir einen Vorschlag machen, hinter dem wir als zukünftiges Projektteam stehen.
Ein gutes Angebot ist deshalb für uns nicht der Anfang einer Verhandlung über eine Zahl. Es ist das Ergebnis eines gemeinsamen Verständnisses – und der erste Schritt in eine Zusammenarbeit auf Augenhöhe.
Im zweiten Teil dieser Serie geht es darum, wie diese Zusammenarbeit im laufenden Projekt konkret aussieht: wie wir unsere Projektumgebung aufbauen, gemeinsam priorisieren, Aufgaben übergeben und für Budgettransparenz sorgen.
punkt.de GmbH
Sophienstr. 187
76185 Karlsruhe
Telefon: +49 (721) 9109-0
Telefax: +49 (721) 9109-100
https://www.punkt.de
Geschäftsführer
Telefon: +49 (721) 9109-124
E-Mail: stein@punkt.de


Girls’Day 2026 bei der punkt.de: Erste Program-miererfahrungen mit Micro:bit
Der Girls’Day ist ein bundesweiter Aktionstag, der Mädchen Einblicke in Berufe und Studienfelder gibt, in denen Frauen noch unterrepräsentiert sind, unter anderem in IT und Softwareentwicklung. Genau deshalb unterstützen wir den Girls’Day seit vielen Jahren: Weil frühe, positive Erfahrungen oft den Unterschied machen, ob aus Interesse später echte Perspektive wird.
Warum uns der Girls’Day wichtig ist
Digitale Berufe prägen unsere Zukunft. Umso wichtiger ist es, dass junge Menschen unabhängig von Rollenbildern Zugang dazu bekommen. Beim Girls’Day geht es für uns nicht um ein einmaliges Event, sondern um Orientierung, Selbstvertrauen und darum zu zeigen: Programmieren ist lernbar, kreativ und macht Spaß.
Als Unternehmen mit langjähriger Erfahrung in Entwicklung und Open Source sehen wir es als Teil unserer Verantwortung, Nachwuchs zu fördern und Technik verständlich zu vermitteln – praxisnah, offen und auf Augenhöhe.
So lief der Tag bei punkt.de ab
Die acht ausgeschriebenen Plätze waren schnell belegt. Um 10:00 Uhr ging es mit einer kurzen Vorstellungsrunde los, danach konnten die Teilnehmerinnen direkt starten, alles war vorbereitet: Rechner, Programmablauf, Aufgaben und natürlich Snacks.
Mit Micro:bit haben die Mädchen spielerisch erste Programmierschritte gemacht, begleitet von erfahrenen Entwicklerinnen und Entwicklern aus unserem Team. Nach dem gemeinsamen Mittagessen und einer kleinen Büroführung wurde weitergearbeitet – dann auch an etwas komplexeren Übungen, zum Beispiel kleinen Spielen. Um 16:00 Uhr endete die Veranstaltung.
Stimmen der Teilnehmerinnen
"Ihr wart sehr freundlich und konntet gut helfen."
"Ich fand die freie Zeit zum Programmieren toll."
"Ich fand die freie Zeit voll gut, das es alles gut erklärt war."
"Es war cool dass wir so viel selber ausprobieren konnten und das wir auch das was wir gemacht haben behalten dürfen."
"Es hat sehr viel Spaß gemacht. Alle waren sehr freundlich und ich habe viel gelernt."
Unser Fazit
Der Girls’Day 2026 hat wieder gezeigt, wie viel Potenzial in praktischen Formaten steckt: selbst ausprobieren, Fragen stellen, Unterstützung bekommen und mit einem Erfolgserlebnis nach Hause gehen. Genau deshalb bleiben wir dabei – und freuen uns schon auf den nächsten Girls’Day bei punkt.de!
punkt.de GmbH
Sophienstr. 187
76185 Karlsruhe
Telefon: +49 (721) 9109-0
Telefax: +49 (721) 9109-100
https://www.punkt.de
Geschäftsführer
Telefon: +49 (721) 9109-124
E-Mail: stein@punkt.de

Europäische Hyperscaler und andere Alternativen
In meinem Artikel „Warum Infrastruktur Haltung ist“ habe ich beschrieben, warum ich europäische Infrastrukturlösungen für relevant halte. In diesem Beitrag geht es um den nächsten Schritt: Europäische Optionen sind nicht nur eine Vernunftentscheidung, sondern in vielen Fällen wirkliche Alternativen – je nach Anforderung auch ohne ideologische Scheuklappen.
1) Grundsatzfrage: Brauche ich wirklich Cloud?
Die Frage „Cloud oder eigenes Blech?“ hat sich seit Mitte der 2010er stark verändert. Virtualisierung ist leichter geworden, Hardware stabiler, und die Grenzen zwischen Cloud und On-Prem sind zunehmend fließend.
Das sehen wir auch bei unserem proServer-Produkt: Es läuft immer häufiger selbst in kleinen HA-Setups bereits ab 150 € / Monat.
Und ganz pragmatisch: In den letzten 12 Monaten waren Systeme in der Praxis öfter betroffen, weil Vorschalt-Dienste ausgefallen sind (z. B. CDN/WAF), als weil „ein Server einfach steht“. Hochverfügbarkeit ist wichtig – aber sie entsteht nicht nur durch „mehr Cloud“, sondern durch Architekturentscheidungen.
Trotzdem gibt es gute Gründe für Cloud:
- Skalierbarkeit (Lastspitzen, schnelles Wachstum)
- Resilienz (wenn richtig designt)
- und oft der wichtigste Punkt für IT-Entscheider: Services und Ökosystem Im Zweifel kauft man nicht „Server woanders“, sondern fertige Bausteine, die in die Tool-Landschaft passen (Identity, Logging, Monitoring, Data Services usw.).
Wenn ich also entschieden habe, dass ein Teil meiner IT in die Cloud soll, ist die nächste Frage: Welche Optionen gibt es – auch in Europa?
2) Hyperscaler vs. Cloud: Was ist der Unterschied?
Cloud ist der Oberbegriff für die Bereitstellung von IT-Ressourcen (Server, Speicher, Anwendungen) über das Internet. Sie kann öffentlich (Public Cloud), privat (Private Cloud) oder hybrid sein – und wird von Anbietern jeder Größe angeboten.
Private Cloud kann – je nach Schutzbedarf – auch als Air‑Gapped Cloud umgesetzt werden (physisch/logisch getrennt, ohne direkte Internet-Anbindung), z. B. für Verteidigungs-, Finanz- oder Gesundheitsanwendungen.
Hyperscaler sind eine spezielle Kategorie von Cloud-Anbietern mit globaler Infrastruktur, extremen Skaleneffekten und einem breiten, oft proprietären Service-Portfolio (z. B. AWS, Microsoft Azure, Google Cloud).
Der Kernunterschied
Cloud (allgemein)
Skalierung: flexibel, aber begrenzt
Infrastruktur: gemietet oder selbst betrieben
Ökosystem: je nach Anbieter
Anbieter: viele (klein bis groß)
Hyperscaler
Skalierung: global, sehr schnell, „nahtlos“
Infrastruktur: stark optimiert, häufig eigene Hardware/Software
Ökosystem: sehr breit (von IAM bis KI/Serverless)
Anbieter: wenige globale Player
Warum das wichtig ist: Für viele KMU reicht eine „klassische“ Cloud völlig aus. Hyperscaler spielen ihre Stärke aus, wenn globale Reichweite, extreme Skalierung oder sehr integrierte Plattformdienste wirklich benötigt werden.
3) Europäische Landschaft: viele Alternativen – aber nicht überall „Hyperscale“
Im Cloud-Markt gibt es in Europa viele gute Alternativen: z. B. Hetzner (oft unser Standard für Infrastruktur), Mittwald und weitere Anbieter. Das sind stabile, praxistaugliche Lösungen, die wir selbst gern einsetzen.
Wenn es jedoch um „echte Hyperscale“ (im Sinne von sehr breitem Plattform-Ökosystem und globaler Skalierung) geht, wird die Auswahl kleiner.
4) Gaia‑X: Souveränität durch Regeln statt durch einen „Super-Hyperscaler“
Ein sehr europäischer Ansatz war (und ist) Gaia‑X. Das Projekt ist kein klassischer Cloud-Anbieter, sondern ein föderiertes Modell: viele Anbieter, gemeinsame Prinzipien und Standards (Identität, Compliance, Transparenz, Datenhoheit), sodass sich das Ökosystem für Nutzer konsistenter anfühlt. Gaia-X setzt auf Interoperabilität statt Insellösungen und nachweisbare Regeln/Zertifizierungen statt „Trust me“ – weniger struktureller Lock-in, mehr Steuerbarkeit.
Aktuell kommt wieder Bewegung rein: 2026 sollen erste operative Datenräume live gehen, z. B. für Luftfahrt, Raumfahrt und Gesundheitswesen. Auch internationale Partner (Japan, Kanada) zeigen Interesse. Gaia-X ist damit kein „totes“ Projekt, sondern entwickelt sich weiter – auch wenn die Umsetzung komplex ist und Zeit braucht.
5) Die „neuen alten Player“: europäische Anbieter mit Ambition
Neben dem föderierten Ansatz gibt es auch Anbieter, die deutlich in Richtung „Hyperscale“ wachsen – mit Fokus auf DSGVO, Datensouveränität und planbare Betriebsmodelle.
6) Europäische Hyperscaler & Alternativen (Auswahl)
Europäische Cloud-Anbieter im Überblick
Deutsche Telekom (T Cloud Public)
Die Deutsche Telekom positioniert ihre T Cloud Public als europäische Alternative zu US-Hyperscalern, insbesondere für regulierte Branchen und den öffentlichen Sektor. Zentrale Argumente sind Datenstandort, regulatorische Kontrolle und Vertragsgestaltung nach europäischen Standards. Die Plattform basiert auf OpenStack und soll laut Telekom bis Ende 2026 die Lücke zu US-Anbietern bei zentralen Core-Features deutlich verkleinern. Bei Souveränitäts- und Standortfragen ist zu beachten, dass sich Aussagen je nach konkretem Angebot innerhalb des breiteren T-Cloud-Portfolios unterscheiden können.
STACKIT (Schwarz Gruppe)
STACKIT entwickelt sich zunehmend zu einer souveränen europäischen Cloud-Alternative mit klarem Fokus auf Datenschutz und regulatorische Anforderungen. Die Plattform betreibt eigene Rechenzentren in Deutschland und Österreich und erfüllt unter anderem Anforderungen wie BSI C5 sowie ISAE 3000 (SOC 2) und ISAE 3402. Parallel wird die Infrastruktur massiv ausgebaut, unter anderem mit einem neuen Großrechenzentrum in Lübbenau, das bis 2027 realisiert werden soll. Im Vergleich zu AWS, Azure und GCP besteht weiterhin ein deutlicher Abstand bei globaler Reichweite und Plattformbreite.
IONOS
IONOS ist ein etablierter europäischer Anbieter für Hosting- und Cloud-Lösungen, der insbesondere für kleine und mittelständische Unternehmen attraktiv ist. Das Unternehmen setzt auf transparente Preisstrukturen und europäische Datenschutzstandards. Zudem engagiert sich IONOS in Initiativen zur digitalen Souveränität in Europa, darunter Gaia-X.
OVHcloud
OVHcloud zählt zu den größten europäischen Cloud-Anbietern und bietet ein breites Portfolio von Public Cloud über Hosted Private Cloud bis hin zu Bare-Metal- und Dedicated-Servern. Das Unternehmen verfolgt konsequent ein „EU-first“-Narrativ mit Fokus auf Datensouveränität, offenen Standards wie OpenStack sowie eigenen Technologien für Kühlung und Energieeffizienz. OVHcloud betreibt mehrere Dutzend Rechenzentren weltweit.
Scaleway
Scaleway richtet sich stark an Entwicklerteams und bietet einen pragmatischen Einstieg in Cloud-Infrastrukturen ohne unmittelbare Bindung an US-Hyperscaler-Ökosysteme. Das Portfolio umfasst unter anderem ARM-basierte Instanzen, Serverless-Angebote und Managed Kubernetes. Die Services werden aus europäischen Regionen wie Paris, Amsterdam und Warschau bereitgestellt.
evroc
evroc ist ein vergleichsweise neuer europäischer Cloud-Anbieter mit Fokus auf Nachhaltigkeit und digitale Souveränität. Seit 2025 sind erste Cloud- und AI-Services verfügbar. Aufgrund des frühen Entwicklungsstadiums sollten Leistungsumfang, verfügbare Regionen und Service-Level je nach Anwendungsfall im Detail geprüft werden.
7) Fazit: Haltung + Flexibilität schließen sich nicht aus
Für uns heißt das: Wir wollen nicht dogmatisch sein. Wir wollen saubere Architekturentscheidungen treffen:
- Was muss wirklich Hyperscaler sein?
- Was kann europäisch, souverän und trotzdem wirtschaftlich laufen?
- Wie vermeiden wir Lock-in – technisch und vertraglich?
Wer heute Infrastruktur plant, sollte Optionen kennen. Wir beschäftigen uns bewusst mit dem Markt, behalten unsere Haltung zu Souveränität im Blick – und bleiben dort flexibel, wo es sinnvoll ist.
Quellen & Weiterführendes
- Gaia-X: Aktueller Stand und Perspektiven
- T Cloud Public: Europäische Hyperscaler-Alternative
- STACKIT: Souveräne Cloud für Unternehmen
- OVHcloud: Europäische Infrastruktur
- Scaleway: Entwicklerfokus & Nachhaltigkeit
- Grüne Rechenzentren: EU-Strategie
- Partnerschaft BWI/Google: „eigene Cloud“ (Air-Gapped/abgetrennte Cloud im Verteidigungsumfeld)
- Schwarz Digits Datacenter Lübbenau (11‑Mrd.-Investition)
punkt.de GmbH
Sophienstr. 187
76185 Karlsruhe
Telefon: +49 (721) 9109-0
Telefax: +49 (721) 9109-100
https://www.punkt.de
Geschäftsführer
Telefon: +49 (721) 9109-124
E-Mail: stein@punkt.de

Die 5 Gründe, auf die Hannover Messe zu gehen
Damit ihr wisst, was euch dort erwartet, haben wir hier unseren persönlichen Blick auf die Messe zusammengefasst – basierend auf unseren Erfahrungen der letzten Jahre.
Grund 1:
Zukunft erleben
Wer auf der Hannover Messe unterwegs ist, erlebt ein außergewöhnlich breites Spektrum: von klassischer Industrie über Automatisierung bis hin zu neuen, teils sehr futuristischen Technologien.
Man bekommt ein gutes Gefühl dafür, was heute bereits möglich ist – und welche Entwicklungen in den kommenden Jahren relevant werden können.
Grund 2:
Networking und Überblick
Ich selbst bin seit über 15 Jahren in diesem Umfeld tätig und bin trotzdem jedes Jahr aufs Neue überrascht, welche Unternehmen dort vertreten sind und wie international die Messe aufgestellt ist.
Die Hannover Messe bringt Unternehmen, Expert:innen und Entscheider:innen aus zahlreichen Ländern zusammen und bietet damit einen einzigartigen Überblick über Märkte, Lösungen und Trends.
Grund 3:
Echter Know-how-Austausch
Neben klassischen Sales-Pitches trifft man auf der Hannover Messe immer wieder Menschen, die ihre Industrie wirklich tief verstehen.
Dieser fachliche Austausch auf Augenhöhe – oft spontan und ungeplant – ist einer der größten Mehrwerte der Messe und macht sie weit mehr als nur zu einer Produktausstellung.
Grund 4:
Innovationen verstehen
Wie in jedem Markt gilt auch hier: Nicht jeder Trend wird sich durchsetzen.
Auf der Hannover Messe kann man sich selbst ein Bild davon machen, welche Technologien Substanz haben, was möglicherweise nur ein kurzfristiger Hype ist und welche Nischen zwar klein, aber dennoch strategisch spannend sein können.
Grund 5:
Optimismus spüren
Die wirtschaftlichen und gesellschaftlichen Herausforderungen sind groß – das ist kein Geheimnis.
Und natürlich ist auch auf der Hannover Messe nicht alles eitel Sonnenschein. Aber die Vielzahl an innovativen Ideen, engagierten Unternehmen und kreativen Lösungsansätzen sorgt bei mir jedes Jahr dafür, die Messe optimistischer zu verlassen, als ich sie betreten habe.
Und was macht jetzt die punkt.de dort?
Seit über 30 Jahren digitalisieren wir den deutschen Mittelstand – konsequent Open Source, datensensibel und mit echter Datensouveränität. Dieses Jahr sind wir nicht nur als Besucher:innen auf der Hannover Messe, sondern erstmals auch aktiv vor Ort vertreten.
Als Teil des Gemeinschaftsstands Baden-Württemberg (THE LÄND) – der offiziellen Standortinitiative des Landes – sind wir auf der Messe präsent. Wir freuen uns darauf, mit vielen Unternehmen aus dem deutschen Mittelstand ins Gespräch zu kommen und gemeinsam an einem unabhängigen, digitalen Wirtschaftsstandort Deutschland zu arbeiten.
Wenn ihr noch Tickets für die Hannover Messe benötigt, meldet euch gerne bei uns.
Die punkt.de ist vom 20. bis 24. April auf der Hannovermesse.
Gemeinschaftsstand „THE LÄND“, Halle 14, Stand: J40
punkt.de GmbH
Sophienstr. 187
76185 Karlsruhe
Telefon: +49 (721) 9109-0
Telefax: +49 (721) 9109-100
https://www.punkt.de
Digital Consultant
Telefon: +49 (721) 91090
E-Mail: info@punkt.de

CI/CD als Kultur – wie wir durch automatisierte Qualität skalieren
Gerade weil CI/CD kein Trendthema mehr ist, halten wir es für umso wichtiger, darüber zu sprechen, wie man es im Projektalltag wirklich lebt. Technologien ändern sich, Anforderungen an Betrieb und Sicherheit steigen, Systeme werden komplexer. CI/CD ist deshalb kein einmal gelöstes Problem, sondern ein kontinuierlicher Prozess, der gepflegt, weiterentwickelt und immer wieder hinterfragt werden muss.
CI/CD als Kultur, nicht als Setup
Für uns ist CI/CD kein Toolset und kein Architektur-Baustein, den man am Projektanfang definiert und dann abhakt. CI/CD ist eine Grundentscheidung darüber, wie Software gebaut, ausgeliefert und betrieben wird. Es geht nicht darum, dass es eine Pipeline gibt, sondern darum, welche Verantwortung diese Pipeline übernimmt.
Wenn CI/CD richtig gelebt wird, sorgt es dafür, dass Qualität nicht von einzelnen Personen abhängt, sondern systemisch abgesichert ist. Automatisierung ist dabei kein Komfortgewinn, sondern die Grundlage für Verlässlichkeit.
Automatisierte Qualität als Voraussetzung für Skalierung
Qualität entsteht für uns nicht durch manuelle Abnahmen oder einzelne Quality Gates am Ende eines Prozesses. Qualität entsteht durch konsequente Automatisierung entlang des gesamten CI/CD-Flows. Automatisierte Qualität bedeutet, dass jede Änderung überprüfbar, reproduzierbar und bewertbar ist – ohne Sonderwege.
Wenn ein Change nicht automatisiert gebaut, getestet und ausgeliefert werden kann, ist er nicht fertig. Diese Konsequenz ist unbequem, besonders in frühen Projektphasen. Sie ist aber entscheidend, um Qualität mit wachsender Codebasis, mehr Beteiligten und höherem Änderungsdruck überhaupt skalieren zu können.
CI/CD erzeugt Geschwindigkeit – wenn Qualität automatisiert ist
CI/CD wird oft mit Geschwindigkeit gleichgesetzt. Für uns ist Geschwindigkeit ein Ergebnis, kein Ziel. Sie entsteht dann, wenn automatisierte Qualität Vertrauen schafft. Vertrauen darin, dass Änderungen klein bleiben, dass Fehler früh sichtbar werden und dass Deployments keine Überraschungen enthalten.
Wenn ein Deployment Angst macht, ist das kein Teamproblem, sondern ein CI/CD-Problem. In solchen Fällen fehlt fast immer automatisierte Qualität – sei es in Tests, in der Infrastruktur oder im Monitoring.
CI/CD endet nicht bei der Pipeline
CI/CD funktioniert nur dann nachhaltig, wenn Infrastruktur Teil des Systems ist. Deployment-Logik, Laufzeitumgebung, Observability sowie Backup- und Recovery-Strategien sind integraler Bestandteil automatisierter Qualität. Eine Anwendung, die zwar getestet ist, deren Betrieb aber nicht automatisiert und beobachtbar ist, bleibt ein Risiko.
CI/CD ist deshalb immer auch ein Infrastruktur- und Betriebsthema. Und weil sich Technologien, Plattformen und Anforderungen ändern, muss auch CI/CD kontinuierlich weiterentwickelt werden.
Warum CI/CD ohne Konsequenz nicht funktioniert
Viele Teams haben CI/CD. Wenige Teams verlassen sich wirklich darauf. Der Unterschied liegt nicht im Tooling, sondern im Anspruch. Wird die CI/CD-Pipeline umgangen, wenn sie nervt? Gibt es manuelle Ausnahmen für „wichtige“ Releases? Oder ist automatisierte Qualität so fest verankert, dass Abkürzungen unnötig werden?
Unser Ziel ist immer Letzteres. CI/CD soll Verantwortung aus einzelnen Köpfen in Systeme überführen – nicht zusätzliche Abhängigkeiten schaffen.
CI/CD für technische Entscheider:innen
Für technische Entscheider:innen ist CI/CD vor allem ein Mittel zur Risikominimierung. Automatisierte Qualität sorgt dafür, dass Projekte nicht an einzelnen Personen hängen, dass Betrieb von Anfang an mitgedacht wird und dass Anwendungen auch nach dem Go-live stabil weiterentwickelt werden können.
CI/CD ist in diesem Kontext keine technische Spielerei, sondern eine Investition in Planbarkeit und Zukunftsfähigkeit.
CI/CD und automatisierte Qualität für bestehende Entwicklungsteams
Gleichzeitig richten wir uns an technische Anwendungsverantwortliche, die bereits Entwicklungsteams haben, aber Unterstützung beim Aufbau und Betrieb von CI/CD-Strukturen benötigen. Wir integrieren uns in bestehende Setups und schaffen CI/CD-Prozesse, die automatisierte Qualität und verlässlichen Betrieb ermöglichen – unabhängig davon, wo entwickelt wird.
Fazit
CI/CD ist kein Setup, kein Sprint-Ziel und keine Tool-Entscheidung. CI/CD ist eine kulturelle Entscheidung. Eine Entscheidung dafür, Qualität nicht zu verhandeln, sondern durch Automatisierung abzusichern. Automatisierte Qualität ist dabei der Schlüssel, um Softwareprojekte auch bei wachsender Komplexität beherrschbar zu halten.
Gerade weil CI/CD kein Hype mehr ist, bleibt es relevant. Wer kontinuierlich daran arbeitet, bleibt handlungsfähig. Wer stehen bleibt, merkt es meist erst, wenn es weh tut.
punkt.de GmbH
Sophienstr. 187
76185 Karlsruhe
Telefon: +49 (721) 9109-0
Telefax: +49 (721) 9109-100
https://www.punkt.de
Geschäftsführer
Telefon: +49 (721) 9109-124
E-Mail: stein@punkt.de

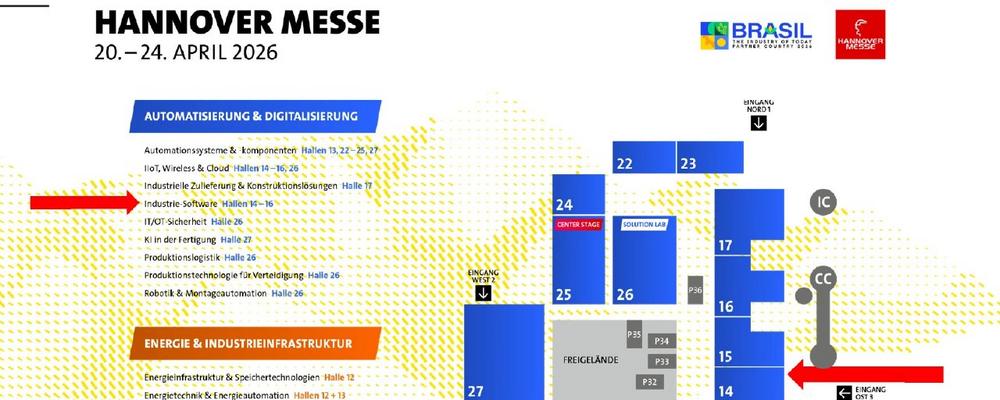
Hannovermesse 2026 / THE LÄND – Wir sind dabei!
Wir freuen uns sehr, dieses Jahr Teil der Initiative „THE LÄND“ des Landes Baden-Württemberg zu sein und unser Bundesland im Ausstellungsbereich „Industrie-Software“ in Sachen Digitalisierung zu vertreten.
Wir bringen unsere Expertise aus den letzten 30 Jahren in den Bereichen Entwicklung und Hosting aus Karlsruhe nach Hannover, um vor Ort mit der produzierenden Industrie über sinnvolle Digitalisierung mit Open Source zu sprechen.
Wenn dich oder dein Unternehmen folgende Themen beschäftigen:
- Digitale Souveränität
- Anwendungsentwicklung mit Open Source
- Sicheres Hosting & Managed Services
- Digitalisierung mit Open Source
Dann kontaktiere uns oder komm uns besuchen am "THE LÄND" -Stand:
Gemeinschaftsstand "THE LÄND"
Halle 14
Stand: J40
In den kommenden Wochen werden wir weitere Informationen auf unserem Blog sowie auf unseren Social-Media-Kanälen bereitstellen!
punkt.de GmbH
Sophienstr. 187
76185 Karlsruhe
Telefon: +49 (721) 9109-0
Telefax: +49 (721) 9109-100
https://www.punkt.de
Geschäftsführer
Telefon: +49 (721) 9109-124
E-Mail: stein@punkt.de
