❌ MS SQL Server ❌ Microsoft SQL Server beschleunigen und sensible Daten gezielt schützen ❗
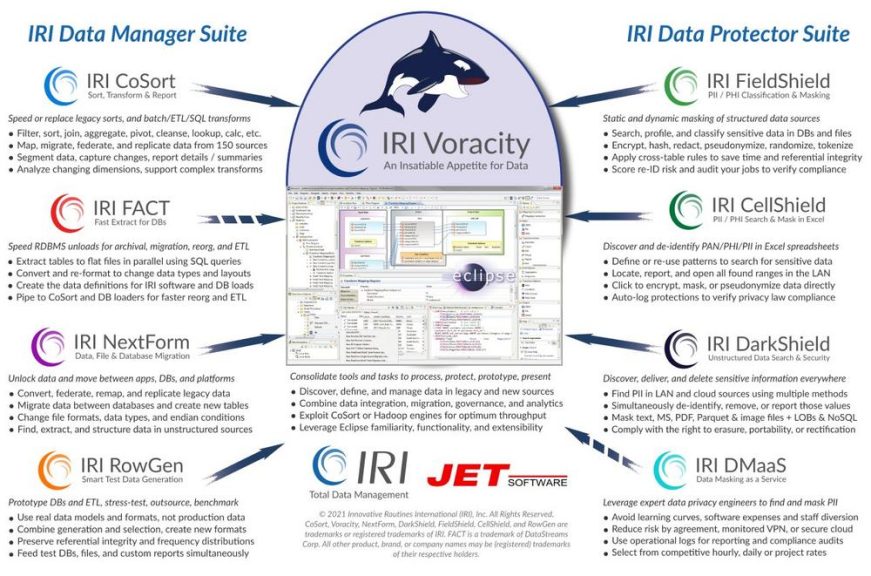
Mit den Technologien von Innovative Routines International (IRI Inc.) bietet JET-Software GmbH leistungsfähige Lösungen, um Microsoft SQL Server zu entlasten, Datenverarbeitungsprozesse zu beschleunigen und sensible Informationen gezielt zu schützen. Dabei lassen sich Datenintegration, Datenmigration, Datenmaskierung und Testdatengenerierung miteinander verbinden.
SQL Server Performance steigern und ETL-Prozesse effizienter gestalten:
Die Verarbeitung großer Datenbestände gehört zu den größten Herausforderungen moderner Datenbankumgebungen. Langsame Ladeprozesse, aufwendige Datenbankreorganisationen und ressourcenintensive SQL-Abfragen können die Systemleistung beeinträchtigen und gleichzeitig hohe Betriebskosten verursachen.
Ein besonders wirksamer Ansatz besteht darin, rechenintensive Operationen aus der Datenbank auszulagern und mit spezialisierten Datenverarbeitungswerkzeugen durchzuführen.
Mit IRI FACT (Fast Extract) lassen sich große SQL Server-Tabellen effizient extrahieren. Die anschließende Verarbeitung erfolgt über IRI CoSort, dessen SortCL-Engine umfangreiche Datenoperationen wie Sortieren, Zusammenführen, Filtern, Gruppieren und Transformieren außerhalb der Datenbank ausführt.
Durch parallele Datenverarbeitung und Multithreading können vorhandene Systemressourcen gezielt genutzt werden. Gleichzeitig wird die SQL Server-Datenbank von zusätzlichen Verarbeitungsaufgaben entlastet.
Auch beim Laden großer Datenmengen bietet CoSort Vorteile. Werden Eingabedaten bereits vor dem Import entsprechend den Indexschlüsseln sortiert, können nachgelagerte Lade- und Indexierungsprozesse effizienter ablaufen.
Microsoft SSIS und Power BI durch externe Datenverarbeitung entlasten:
Viele Unternehmen verwenden Microsoft SQL Server Integration Services (SSIS) für Datenintegration und ETL-Prozesse. Bei wachsenden Datenmengen und komplexen Transformationen können jedoch lange Laufzeiten entstehen.
IRI CoSort und die Datenmanagementplattform IRI Voracity ermöglichen es, besonders rechenintensive Datenverarbeitungsschritte außerhalb der Datenbank auszuführen. Bestehende ETL-Prozesse können dadurch ergänzt, beschleunigt oder bei Bedarf durch alternative Verarbeitungsschritte ersetzt werden.
Auch Microsoft Power BI profitiert von einer effizienten Datenvorbereitung. Werden umfangreiche Datenbestände bereits vor der Übergabe an die Analyseplattform bereinigt, transformiert, aggregiert und konsolidiert, lässt sich der Verarbeitungsaufwand innerhalb der BI-Umgebung reduzieren.
Die visuelle Entwicklungsumgebung IRI Workbench auf Eclipse-Basis ermöglicht dabei die zentrale Gestaltung und Verwaltung entsprechender Datenmanagementprozesse.
Datenmigration, Datenqualität und SQL Server-Reorganisation automatisieren:
Neben der reinen Performance gewinnt die flexible Migration und Integration von Daten zunehmend an Bedeutung. Unternehmen müssen Daten zwischen unterschiedlichen Datenbanken, Anwendungen und Plattformen übertragen, konvertieren oder zusammenführen.
Mit IRI NextForm, CoSort und Voracity lassen sich Datenstrukturen anpassen, Formate konvertieren und SQL Server-Daten für neue Zielsysteme aufbereiten.
Darüber hinaus unterstützen die Lösungen die Verbesserung der Datenqualität. Fehlerhafte, doppelte oder uneinheitlich formatierte Informationen können erkannt, bereinigt und standardisiert werden.
Für klassische Offline-Reorganisationen steht innerhalb der IRI Workbench ein entsprechender Assistent zur Verfügung. Dieser kombiniert das Extrahieren, Sortieren und erneute Laden von Tabellen, um Datenbankbestände effizient neu zu organisieren.
SQL Server Datenmaskierung und DSGVO-konforme Datenverarbeitung:
Mit der zunehmenden Verarbeitung personenbezogener Daten steigen auch die Anforderungen an Datenschutz und Datensicherheit. Unternehmen müssen sicherstellen, dass vertrauliche Informationen nicht unkontrolliert in Entwicklungs-, Test-, Analyse- oder Cloud-Umgebungen gelangen.
IRI FieldShield ermöglicht die Erkennung, Klassifizierung und Maskierung sensibler Daten in SQL Server-Tabellen. Dazu zählen beispielsweise Namen, Adressen, Kontoinformationen und weitere personenbezogene Daten.
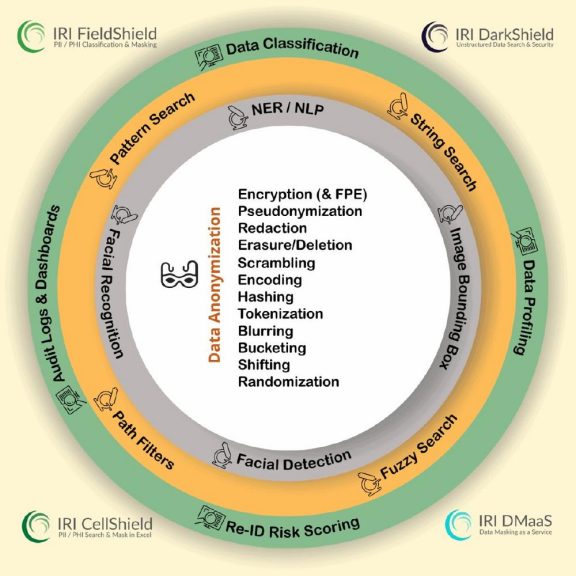
Neben statischer und dynamischer Datenmaskierung stehen Verfahren wie Pseudonymisierung, Verschlüsselung, Tokenisierung und formatbewahrende Verschlüsselung zur Verfügung. Dadurch können sensible Informationen geschützt werden, während benötigte Datenstrukturen und Formate erhalten bleiben.
IRI DarkShield ergänzt diese Funktionen durch die Erkennung und Maskierung sensibler Inhalte in semi- und unstrukturierten Informationen, beispielsweise innerhalb von SQL Server FILESTREAM-Daten.
Beide Lösungen können optional mit Azure Key Vault für die Verwaltung kryptografischer Schlüssel kombiniert werden.
Damit unterstützt die Datenmaskierung Unternehmen bei der Umsetzung technischer Datenschutzmaßnahmen gemäß DSGVO, ohne die betriebliche Nutzung von Daten unnötig einzuschränken.
Realistische SQL Server-Testdaten ohne unnötige Datenschutzrisiken:
Moderne Softwareentwicklung benötigt große Mengen realistischer Testdaten. Die Verwendung personenbezogener Produktionsdaten ist dabei jedoch mit erheblichen Datenschutzrisiken verbunden.
Mit IRI RowGen lassen sich synthetische Testdaten für SQL Server-Datenbanken generieren. Die Software berücksichtigt bestehende Datenmodelle und kann Beziehungen zwischen Tabellen erhalten, sodass auch komplexe Anwendungsszenarien realitätsnah getestet werden können.
Alternativ lassen sich mit Datenbank-Subsetting gezielte Teilmengen vorhandener Produktionsdaten erzeugen und mit FieldShield maskieren.
Die Einbindung von FieldShield und RowGen in Azure DevOps ermöglicht zusätzlich eine automatisierte Bereitstellung von Testdaten innerhalb moderner CI/CD-Prozesse.
Datenmanagement für Microsoft SQL Server zentralisieren:
Mit IRI Voracity lassen sich unterschiedliche Aufgaben der Datenverarbeitung auf einer gemeinsamen Plattform zusammenführen. Dazu gehören Datenextraktion, ETL, Datenmigration, Datenqualität, Datenmaskierung und Testdatengenerierung.
Unternehmen profitieren von der Möglichkeit, bestehende SQL Server-Umgebungen gezielt zu optimieren, ohne sämtliche Anwendungen oder Datenbankstrukturen ersetzen zu müssen.
JET-Software unterstützt Unternehmen und öffentliche Einrichtungen bei der Auswahl und Integration passender IRI-Technologien für Microsoft SQL Server, hybride IT-Landschaften sowie lokale und cloudbasierte Datenverarbeitung.
Das Ergebnis sind effizientere Datenbankoperationen, geringere Verarbeitungslasten und ein höheres Schutzniveau für sensible Unternehmensdaten!
Effizienz trifft Erfahrung: Seit mehr als vier Jahrzehnten unterstützen unsere Softwarelösungen Unternehmen bei Datenmanagement und Datenschutz – technologisch führend, zuverlässig im produktiven Einsatz und branchenübergreifend einsetzbar.
Seit 1978 im Einsatz: Zahlreiche namhafte Unternehmen, Dienstleister, Finanzinstitute sowie Landes- und Bundesbehörden zählen zu unseren langjährigen Kunden – nationale Referenzen sind hier gelistet und internationale Referenzen sind hier zusammengefasst.
Maximale Kompatibilität: Unsere Software unterstützt sowohl klassische Mainframe-Plattformen (Fujitsu BS2000/OSD, IBM z/OS, z/VSE, z/Linux) als auch moderne Open-System-Umgebungen wie Linux, UNIX-Derivate und Windows.
JET-Software
Edmund-Lang-Straße 16
64832 Babenhausen
Telefon: +49 (6073) 711-403
Telefax: +49 (6073) 711-405
https://www.jet-software.com
Telefon: +49 (6073) 711403
Fax: +49 (6073) 711405
E-Mail: amadeus.thomas@jet-software.com

❌ NoSQL-Daten schützen ❌ IRI DarkShield erweitert Datenmaskierung auf Splunk, Redis und Azure Cosmos DB ❗
Personenbezogene Informationen können sich in Logdaten, JSON-Dokumenten, Event Streams oder Key-Value-Strukturen verbergen. Unternehmen verlieren dadurch leicht den Überblick darüber, wo sensible Daten gespeichert sind und wer darauf zugreifen kann. Das erschwert eine einheitliche Umsetzung von Datenschutzrichtlinien und die Erfüllung von Anforderungen wie der DSGVO.
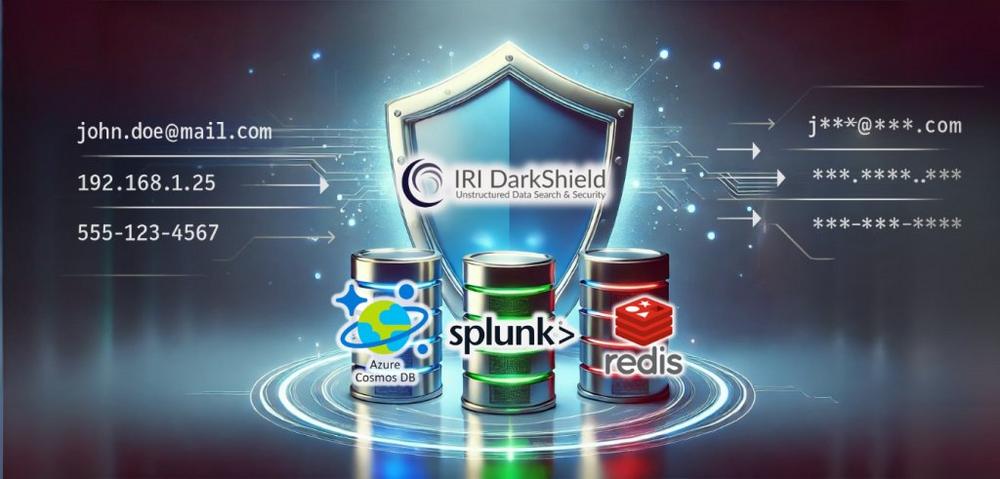
IRI DarkShield unterstützt Unternehmen dabei, sensible Daten in strukturierten, semi-strukturierten und unstrukturierten Daten zu finden, zu klassifizieren und zu maskieren. Neben Cassandra, Elasticsearch und MongoDB unterstützt DarkShield auch Splunk, Redis und Azure Cosmos DB. So lässt sich der Schutz personenbezogener Daten über unterschiedliche Plattformen hinweg umsetzen.
Typische Herausforderungen beim Datenschutz in NoSQL-Umgebungen sind fehlende Transparenz über sensible Datenbestände, uneinheitliche Maskierungsverfahren und unterschiedliche Datenschutzmechanismen je Plattform. Hinzu kommen ungeschützte Informationen in Entwicklungs-, Analyse- und Testumgebungen sowie der Aufwand, Anforderungen aus DSGVO, HIPAA oder PCI DSS zu berücksichtigen.
Klassische Data-Masking-Ansätze für relationale Datenbanken reichen dafür oft nicht aus. NoSQL-Systeme verarbeiten dynamische und unterschiedlich strukturierte Daten. Unternehmen benötigen daher flexible Lösungen, die sensible Informationen automatisiert erkennen und Datenschutzregeln über verschiedene Datenquellen hinweg anwenden können.
IRI DarkShield bietet dafür Funktionen wie die Erkennung von PII und PHI, statisches und dynamisches Data Masking sowie Pseudonymisierung, Tokenisierung, Verschlüsselung und regelbasierte Redaktion. Der Schutz kann auf strukturierte, semi-strukturierte und unstrukturierte Daten angewendet werden.
So können Unternehmen ihre Datenschutzrichtlinien auch in komplexen NoSQL-Umgebungen konsistent umsetzen und die Daten weiterhin für Analysen, Entwicklung und Tests nutzen. Moderne Datensicherheit endet nicht bei relationalen Datenbanken: Gerade in verteilten NoSQL-Systemen wird eine plattformübergreifende PII-Protection zu einem wichtigen Faktor für Datenschutz, Compliance und Vertrauen.
Effizienz trifft Erfahrung: Seit mehr als vier Jahrzehnten unterstützen unsere Softwarelösungen Unternehmen bei Datenmanagement und Datenschutz – technologisch führend, zuverlässig im produktiven Einsatz und branchenübergreifend einsetzbar.
Seit 1978 im Einsatz: Zahlreiche namhafte Unternehmen, Dienstleister, Finanzinstitute sowie Landes- und Bundesbehörden zählen zu unseren langjährigen Kunden – nationale Referenzen sind hier gelistet und internationale Referenzen sind hier zusammengefasst.
Maximale Kompatibilität: Unsere Software unterstützt sowohl klassische Mainframe-Plattformen (Fujitsu BS2000/OSD, IBM z/OS, z/VSE, z/Linux) als auch moderne Open-System-Umgebungen wie Linux, UNIX-Derivate und Windows.
JET-Software
Edmund-Lang-Straße 16
64832 Babenhausen
Telefon: +49 (6073) 711-403
Telefax: +49 (6073) 711-405
https://www.jet-software.com
Telefon: +49 (6073) 711403
Fax: +49 (6073) 711405
E-Mail: amadeus.thomas@jet-software.com

❌ Datenlecks bei KFC ❌ Gezielte Datenmaskierung schützt sensible Informationen sofort ❗
Cyberangriffe auf Unternehmen und Behörden zeigen, wie gefährdet personenbezogene Daten sind. Mit intelligenter Datenmaskierung lassen sich vertrauliche Informationen schützen und die Folgen möglicher Datenlecks erheblich reduzieren.
Cyberangriffe, Ransomware und Datenlecks stellen Unternehmen zunehmend vor Herausforderungen. Im Oktober 2026 geriet die internationale Fast-Food-Kette KFC in die Schlagzeilen, nachdem die Ransomware-Gruppe „The Gentlemen“ behauptete, das Unternehmen angegriffen zu haben. Ein tatsächlicher Datendiebstahl ist bislang nicht unabhängig bestätigt. In Deutschland zeigen dagegen dokumentierte Sicherheitsvorfälle beim Onlinehändler asgoodasnew und in der Berliner Verwaltung, wie schnell personenbezogene und geschäftskritische Daten in falsche Hände gelangen können.
Datenlecks in Deutschland: Millionen Kundendaten und Behördeninformationen gefährdet!
Im März 2026 wurde der deutsche Onlinehändler asgoodasnew Opfer eines Cyberangriffs. Nach Angaben der Verbraucherzentralen könnten rund 1,8 Millionen Kundenkonten betroffen sein. Zu den möglicherweise kompromittierten Informationen zählen Namen, Adressen, E-Mail-Adressen, Bestellhistorien und verschlüsselte Passwörter.
Auch öffentliche Einrichtungen bleiben nicht verschont. Im August 2026 wurden bei einem Cyberangriff auf Teile der Berliner Verwaltungsnetze umfangreiche Daten kopiert und anschließend veröffentlicht. Betroffen waren unter anderem personenbezogene Informationen von Verwaltungsbeschäftigten sowie möglicherweise von Bürgerinnen und Bürgern.
Solche Vorfälle zeigen, dass nicht allein der unbefugte Zugriff auf IT-Systeme problematisch ist. Entscheidend ist vor allem, welche sensiblen Informationen Angreifer tatsächlich erlangen und anschließend missbrauchen können.
Datenmaskierung reduziert die Folgen eines Cyberangriffs!
Klassische Sicherheitsmaßnahmen wie Firewalls, Zugriffskontrollen und Verschlüsselung bleiben unverzichtbar. Doch was geschieht, wenn Angreifer diese Schutzmechanismen überwinden und Zugriff auf gespeicherte Informationen erhalten?
Hier setzt die Datenmaskierung (Data Masking) an. Sensible Informationen werden gezielt anonymisiert, pseudonymisiert oder durch geschützte Ersatzwerte ersetzt. Dadurch lassen sich Daten weiterhin für viele betriebliche Zwecke nutzen, ohne überall personenbezogene Originalinformationen bereitzustellen.
Besonders in Entwicklungs-, Test-, Analyse- und Cloud-Umgebungen ist dies entscheidend. Werden produktive Datenbestände kopiert, entstehen zusätzliche potenzielle Angriffsflächen. Eine frühzeitige Maskierung kann verhindern, dass diese Kopien unnötig vertrauliche Informationen enthalten.
IRI FieldShield und IRI DarkShield: Sensible Daten automatisch erkennen und maskieren!
Mit IRI FieldShield und IRI DarkShield bietet JET-Software leistungsfähige Lösungen zur automatisierten Datenmaskierung unterschiedlichster Datenquellen.
IRI FieldShield schützt strukturierte Informationen in relationalen Datenbanken und Dateien. Dazu gehören beispielsweise Kundenstammdaten, Kontonummern, Adressen und weitere personenbezogene Merkmale. Unterstützt werden unter anderem Pseudonymisierung, Tokenisierung, Verschlüsselung und formatbewahrende Verschlüsselung (FPE).
IRI DarkShield erweitert die Datenmaskierung auf semi- und unstrukturierte Informationen. Dazu zählen PDF-Dokumente, Office-Dateien, Bilder, JSON- und XML-Daten sowie NoSQL-Datenbanken. Mithilfe intelligenter Suchverfahren, regulärer Ausdrücke und KI-gestützter Erkennung lassen sich sensible Inhalte automatisiert identifizieren und gezielt schützen.
Über die Datenmanagementplattform IRI Voracity können Unternehmen diese Funktionen sogar mit Datenintegration, Datenklassifizierung und weiteren Datenschutzprozessen verbinden!
DSGVO und Datenschutz: Risiken bereits vor einem Datenleck minimieren!
Die Datenschutz-Grundverordnung (DSGVO) verlangt geeignete technische und organisatorische Maßnahmen zum Schutz personenbezogener Daten. Datenmaskierung unterstützt insbesondere die Prinzipien der Datenminimierung, der Vertraulichkeit und des Datenschutzes durch Technikgestaltung.
Unternehmen können so Risiken reduzieren, wenn personenbezogene Daten für Softwareentwicklung, Testdatenmanagement, Business Intelligence, Cloud-Migration oder KI-Anwendungen benötigt werden.
Entscheidend ist dabei die Wahl des geeigneten Maskierungsverfahrens: Während eine wirksame Anonymisierung die Identifizierbarkeit dauerhaft beseitigen soll, bleiben pseudonymisierte Daten grundsätzlich weiterhin personenbezogen und unterliegen damit der DSGVO.
Daten schützen, bevor ein Datenleck entsteht!
Die Vorfälle bei KFC, asgoodasnew und der Berliner Verwaltung verdeutlichen die Bedeutung eines umfassenden Datenschutzkonzepts. Während der mutmaßliche Angriff auf KFC noch ungeklärt ist, zeigen die bestätigten deutschen Sicherheitsvorfälle konkrete Risiken für Unternehmen, Behörden und betroffene Personen.
Datenmaskierung verhindert zwar nicht jeden Cyberangriff, kann jedoch dafür sorgen, dass kompromittierte Datenbestände deutlich weniger sensible Informationen preisgeben.
Mit FieldShield, DarkShield und Voracity unterstützt JET-Software Unternehmen und öffentliche Einrichtungen bei der sicheren Verarbeitung, Bereitstellung und Nutzung vertraulicher Informationen in heterogenen IT-Landschaften.
Denn wirksamer Datenschutz beginnt nicht erst beim Cyberangriff, sondern bereits bei der gezielten Absicherung der Daten selbst.
Effizienz trifft Erfahrung: Seit mehr als vier Jahrzehnten unterstützen unsere Softwarelösungen Unternehmen bei Datenmanagement und Datenschutz – technologisch führend, zuverlässig im produktiven Einsatz und branchenübergreifend einsetzbar.
Seit 1978 im Einsatz: Zahlreiche namhafte Unternehmen, Dienstleister, Finanzinstitute sowie Landes- und Bundesbehörden zählen zu unseren langjährigen Kunden – nationale Referenzen sind hier gelistet und internationale Referenzen sind hier zusammengefasst.
Maximale Kompatibilität: Unsere Software unterstützt sowohl klassische Mainframe-Plattformen (Fujitsu BS2000/OSD, IBM z/OS, z/VSE, z/Linux) als auch moderne Open-System-Umgebungen wie Linux, UNIX-Derivate und Windows.
Sparen Sie Zeit und Geld bei der Manipulation oder dem Schutz Ihrer Daten mit unserer bewährten Low-Code-Datenmanagement- und Maskierungssoftware. Wir verbinden modernste Technologie mit jahrzehntelanger Erfahrung in der Verarbeitung von Produktionsdaten auf verschiedenen Plattformen und in unterschiedlichen Branchen.
Mit unserer Software können Sie:
Große Sortier- und ETL-Aufträge beschleunigen
Beschleunigung von Datenbank-Entladungen, -Ladungen, -Reorgs und -Abfragen
Konvertieren und Neuformatieren von alten Datentypen, Dateien und Datenbanken
Erstellung benutzerdefinierter Berichte oder Aufbereitung von Daten für Analysen und KI
Ersetzen von alten ETL-, SQL- und Sortieraufträgen
Suchen, Extrahieren und Restrukturieren unstrukturierter Daten
Replizieren und Erfassen geänderter Datenbank-Daten in Echtzeit
Filtern, Bereinigen, Anreichern und Standardisieren von Daten
PII klassifizieren, entdecken und de-identifizieren
Daten statisch, dynamisch oder inkrementell maskieren
PHI-Re-ID-Risiko bewerten und Quasi-Identifikatoren anonymisieren
Synthetisieren von strukturell und referenziell korrekten Testdaten
Profitieren Sie von der Leistungsfähigkeit und Flexibilität der preisgekrönten IRI-Lösungen, die von Analysten beraten und durch 40 Partnerbüros weltweit unterstützt werden. Vermeiden Sie die steile Lernkurve und die hohen Kosten von Multi-Tool- und Mega-Anbieter-Lösungen und entdecken Sie die Vorteile schnellerer Design- und Laufzeiten für Ihr Unternehmen.
Die spezifischen Lösungen sind kompatibel mit allen gängigen Betriebssystemen, vom Mainframe (Fujitsu BS2000/OSD, IBM z/OS und z/VSE + z/Linux) bis hin zu Open Systems (UNIX & Derivate, Linux + Windows).
Seit 1978 weltweit anerkannt im B2B-Sektor: Großunternehmen, nationale und internationale Dienstleister, Privat-, Groß-, Landes- und Bundesbanken, Sozial- und Privatversicherungen sowie deutsche, Landes- und Bundesbehörden!
JET-Software
Edmund-Lang-Straße 16
64832 Babenhausen
Telefon: +49 (6073) 711-403
Telefax: +49 (6073) 711-405
https://www.jet-software.com
Telefon: +49 (6073) 711403
Fax: +49 (6073) 711405
E-Mail: amadeus.thomas@jet-software.com

❌ Sichere Testdaten erstellen ❌ Gezielt Datenschutz und Softwarequalität verbinden ❗
Moderne Software muss schnell entwickelt, zuverlässig getestet und kontinuierlich verbessert werden. Dafür benötigen Entwicklungs- und Qualitätssicherungsteams realistische Testdaten. Die direkte Verwendung personenbezogener oder anderer sensibler Produktivdaten birgt jedoch erhebliche Datenschutz- und Sicherheitsrisiken. Ein professionelles Test Data Management schafft die notwendige Verbindung zwischen Datenqualität, Softwarequalität und Datenschutz.
Produktionsnahe Testdaten bilden reale Datenstrukturen, Formate und Beziehungen möglichst genau ab. Dadurch lassen sich Anwendungen unter realistischen Bedingungen prüfen, Fehler frühzeitig erkennen und neue Funktionen zuverlässig validieren. Gleichzeitig dürfen Test- und Entwicklungsumgebungen keine unnötigen Rückschlüsse auf Kunden, Beschäftigte, Patienten oder Geschäftspartner ermöglichen.
Wie lassen sich Produktivdaten sicher für Tests nutzen?
Eine zentrale Methode ist die Datenmaskierung. Dabei werden personenbezogene und vertrauliche Informationen gezielt verändert, ersetzt, verschlüsselt oder pseudonymisiert. Die ursprünglichen Werte sind anschließend nicht mehr erkennbar, während Struktur, Format und fachliche Verwendbarkeit der Daten erhalten bleiben.
Namen, Adressen, Kontodaten, Telefonnummern oder andere schützenswerte Informationen können so realistisch dargestellt werden, ohne die Originalwerte in weniger geschützte Testsysteme zu übernehmen. Die Maskierung unterstützt Unternehmen dabei, Datenschutzvorgaben wie die DSGVO auch in Softwareentwicklung, Qualitätssicherung und DevOps-Prozessen angemessen zu berücksichtigen.
Datenmaskierung oder synthetische Testdaten?
Datenmaskierung und synthetische Datengenerierung verfolgen unterschiedliche Ansätze. Bei der Maskierung dienen vorhandene Datenbestände als Grundlage. Sensible Inhalte werden verändert, während Datenstruktur und fachliche Zusammenhänge erhalten bleiben.
Synthetische Testdaten werden dagegen vollständig neu erzeugt. Sie basieren auf definierten Regeln, Formaten, Wertebereichen und Verteilungen und enthalten keine realen personenbezogenen Ausgangsdaten. Dabei können auch gezielt Sonderfälle, Grenzwerte, ungültige Eingaben oder seltene Konstellationen generiert werden.
Welche Methode besser geeignet ist, hängt vom jeweiligen Anwendungsfall ab. Häufig bietet eine Kombination aus maskierten Produktivdaten und synthetisch erzeugten Datensätzen die größte Flexibilität.
Relevante Datenbestände durch Subsetting verkleinern: Für viele Tests wird keine vollständige Kopie einer produktiven Datenbank benötigt. Database Subsetting reduziert große Datenbestände auf eine kleinere, fachlich relevante Teilmenge. Entscheidend ist dabei, dass Beziehungen zwischen Tabellen und Datensätzen erhalten bleiben.
Ein ausgewählter Kundendatensatz muss beispielsweise weiterhin mit den zugehörigen Adressen, Verträgen, Zahlungen und Vorgängen verbunden sein. Referenziell korrekte Teilmengen reduzieren Speicherbedarf und Bereitstellungszeiten, ohne die Aussagekraft der Tests zu beeinträchtigen.
Automatisierte Testdaten für CI/CD und DevOps: Manuelle Verfahren stoßen bei großen Datenmengen, komplexen Systemlandschaften und kurzen Entwicklungszyklen schnell an ihre Grenzen. Moderne Testdatenprozesse müssen deshalb automatisierbar, wiederholbar und skalierbar sein.
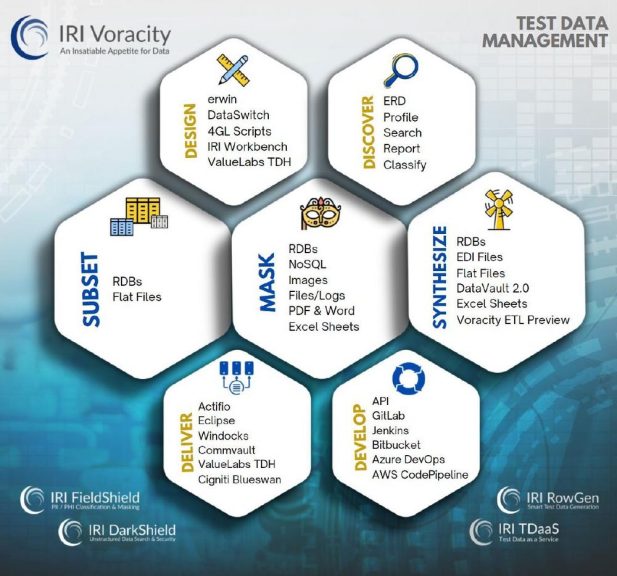
Datenprofiling, Klassifizierung, Maskierung, Transformation, Subsetting und synthetische Datengenerierung lassen sich in standardisierte Abläufe integrieren. Dadurch können benötigte Testdaten bedarfsgerecht bereitgestellt und regelmäßig aktualisiert werden. Die Einbindung in CI/CD-Pipelines unterstützt automatisierte Tests und beschleunigt die Entwicklung neuer Softwareversionen.
Integriertes Test Data Management mit IRI Voracity: IRI Voracity verbindet zentrale Funktionen für Datenmanagement, Datenschutz und Testdatenbereitstellung in einer einheitlichen Plattform. Sensible Daten können identifiziert, klassifiziert, transformiert und mit wiederverwendbaren Regeln geschützt werden.
Die Plattform unterstützt unter anderem:
- Datenprofiling und Erkennung sensibler Informationen
- statische, dynamische und inkrementelle Datenmaskierung
- Erstellung synthetischer Testdaten
- referenziell korrektes Database Subsetting
- Datentransformation und Datenmigration
- Integration in automatisierte Entwicklungs- und CI/CD-Prozesse
Unternehmen können damit Testdatenprozesse zentral gestalten und wiederkehrende Aufgaben automatisieren. Die IRI Workbench stellt dafür eine Eclipse-basierte Entwicklungsumgebung bereit, in der Datenregeln erstellt, verwaltet und über verschiedene Systeme hinweg eingesetzt werden können.
Datenschutz und Softwarequalität gemeinsam verbessern!
Sichere Testdaten sind ein wesentlicher Bestandteil moderner Softwareentwicklung. Sie ermöglichen realistische Tests, ohne sensible Produktivdaten unnötigen Risiken auszusetzen. Datenmaskierung, synthetische Datengenerierung und Database Subsetting schaffen gemeinsam eine belastbare Grundlage für Datenschutz, Testautomatisierung und zuverlässige Softwarequalität.
IRI Voracity führt diese Verfahren in einer integrierten Plattform zusammen. So entstehen wiederholbare und skalierbare Testdatenprozesse, die sich in bestehende Entwicklungsumgebungen einbinden lassen und Unternehmen bei der sicheren Nutzung ihrer Daten unterstützen.
Online-Schulung zum Testdatenmanagement: Wie sichere und realistische Testdaten in der Praxis geplant, erzeugt und automatisiert bereitgestellt werden, zeigt die Online-Schulung Testdatenmanagement – Testdaten sicher und zielgerichtet bereitstellen. Die Teilnehmenden lernen, synthetische Testdaten, Datenmaskierung und Database Subsetting passend zum jeweiligen Testziel einzusetzen. Praxisdemonstrationen mit IRI Voracity, RowGen, FieldShield und DarkShield veranschaulichen die technische Umsetzung in Entwicklungs-, Test-, DevOps- und CI/CD-Prozessen. Der nächste Termin findet am 12. und 13. Januar 2027 statt.
Effizienz trifft Erfahrung: Seit mehr als vier Jahrzehnten unterstützen unsere Softwarelösungen Unternehmen bei Datenmanagement und Datenschutz – technologisch führend, zuverlässig im produktiven Einsatz und branchenübergreifend einsetzbar.
Seit 1978 im Einsatz: Zahlreiche namhafte Unternehmen, Dienstleister, Finanzinstitute sowie Landes- und Bundesbehörden zählen zu unseren langjährigen Kunden – nationale Referenzen sind hier gelistet und internationale Referenzen sind hier zusammengefasst.
Maximale Kompatibilität: Unsere Software unterstützt sowohl klassische Mainframe-Plattformen (Fujitsu BS2000/OSD, IBM z/OS, z/VSE, z/Linux) als auch moderne Open-System-Umgebungen wie Linux, UNIX-Derivate und Windows.
Sparen Sie Zeit und Geld bei der Manipulation oder dem Schutz Ihrer Daten mit unserer bewährten Low-Code-Datenmanagement- und Maskierungssoftware. Wir verbinden modernste Technologie mit jahrzehntelanger Erfahrung in der Verarbeitung von Produktionsdaten auf verschiedenen Plattformen und in unterschiedlichen Branchen.
Mit unserer Software können Sie:
Große Sortier- und ETL-Aufträge beschleunigen
Beschleunigung von Datenbank-Entladungen, -Ladungen, -Reorgs und -Abfragen
Konvertieren und Neuformatieren von alten Datentypen, Dateien und Datenbanken
Erstellung benutzerdefinierter Berichte oder Aufbereitung von Daten für Analysen und KI
Ersetzen von alten ETL-, SQL- und Sortieraufträgen
Suchen, Extrahieren und Restrukturieren unstrukturierter Daten
Replizieren und Erfassen geänderter Datenbank-Daten in Echtzeit
Filtern, Bereinigen, Anreichern und Standardisieren von Daten
PII klassifizieren, entdecken und de-identifizieren
Daten statisch, dynamisch oder inkrementell maskieren
PHI-Re-ID-Risiko bewerten und Quasi-Identifikatoren anonymisieren
Synthetisieren von strukturell und referenziell korrekten Testdaten
Profitieren Sie von der Leistungsfähigkeit und Flexibilität der preisgekrönten IRI-Lösungen, die von Analysten beraten und durch 40 Partnerbüros weltweit unterstützt werden. Vermeiden Sie die steile Lernkurve und die hohen Kosten von Multi-Tool- und Mega-Anbieter-Lösungen und entdecken Sie die Vorteile schnellerer Design- und Laufzeiten für Ihr Unternehmen.
Die spezifischen Lösungen sind kompatibel mit allen gängigen Betriebssystemen, vom Mainframe (Fujitsu BS2000/OSD, IBM z/OS und z/VSE + z/Linux) bis hin zu Open Systems (UNIX & Derivate, Linux + Windows).
Seit 1978 weltweit anerkannt im B2B-Sektor: Großunternehmen, nationale und internationale Dienstleister, Privat-, Groß-, Landes- und Bundesbanken, Sozial- und Privatversicherungen sowie deutsche, Landes- und Bundesbehörden!
JET-Software
Edmund-Lang-Straße 16
64832 Babenhausen
Telefon: +49 (6073) 711-403
Telefax: +49 (6073) 711-405
https://www.jet-software.com
Telefon: +49 (6073) 711403
Fax: +49 (6073) 711405
E-Mail: amadeus.thomas@jet-software.com

❌ Datenmaskierung im BFSI-Sektor ❌ Sensible Finanzdaten und PII von Anfang an sicher schützen ❗
Der Banking-, Finanzdienstleistungs- und Versicherungssektor – kurz BFSI – gehört zu den datenintensivsten Branchen überhaupt. Kontonummern, Kreditkartendaten, persönliche Identifikationsmerkmale, Transaktionsinformationen, Bonitätsdaten oder Kreditunterlagen müssen verarbeitet und gleichzeitig vor unbefugtem Zugriff geschützt werden.
Neben der DSGVO spielen für Finanzunternehmen zusätzliche regulatorische und organisatorische Anforderungen eine wichtige Rolle. Dazu gehören unter anderem PCI DSS sowie in Europa die Vorgaben zur digitalen operationalen Resilienz durch DORA.
Eine wirkungsvolle Möglichkeit, das Risiko beim Arbeiten mit sensiblen Daten zu reduzieren, ist die Datenmaskierung. Dabei werden vertrauliche Werte verändert, ersetzt, pseudonymisiert, verschlüsselt oder geschwärzt, während Struktur und Nutzbarkeit der Daten weitgehend erhalten bleiben.
Warum ist Datenmaskierung für Banken und Versicherungen wichtig?
Viele Geschäftsprozesse benötigen realistische Daten, jedoch nicht zwangsläufig die tatsächlichen Identitäten der Kunden.
Datenmaskierung ermöglicht es deshalb, sensible PII – Personally Identifiable Information – bereits vor der Nutzung in Entwicklungs-, Test-, Analyse- oder externen Umgebungen zu schützen.
Der Vorteil: Anwendungen und Prozesse können weiterhin mit realistischen Datenstrukturen arbeiten, während das Risiko einer Offenlegung echter Kundendaten deutlich reduziert wird.
Sichere Testdaten für DevOps und QA: Banken und Versicherungen entwickeln kontinuierlich neue Anwendungen, mobile Services, Kundenportale und automatisierte Geschäftsprozesse. Für Softwaretests werden Daten benötigt, die Produktivdaten möglichst realistisch abbilden.
Die direkte Nutzung echter Kundendaten in Entwicklungs- und Testsystemen kann jedoch erhebliche Datenschutz- und Sicherheitsrisiken verursachen.
Durch statische Datenmaskierung lassen sich beispielsweise Kontonummern, Kreditkartendaten, Namen oder Identifikationsnummern durch realistische Ersatzwerte ersetzen.
Verfahren wie:
- Format Preserving Encryption (FPE)
- Pseudonymisierung
- Tokenisierung
- Randomisierung
- Scrambling
- Hashing
- Schwärzung
helfen dabei, sensible Informationen zu schützen und gleichzeitig Datenformat und Struktur für Tests zu erhalten.
Besonders bei relationalen Datenbanken ist es wichtig, dass Beziehungen zwischen Tabellen erhalten bleiben. Konsistente und deterministische Maskierung ermöglicht deshalb auch referenziell korrekte Testdaten über mehrere Tabellen und Datenquellen hinweg.
Datenmaskierung über unterschiedliche Datenquellen hinweg!
Sensible Informationen befinden sich längst nicht mehr ausschließlich in relationalen Datenbanken.
PII kann unter anderem vorkommen in: Datenbanken, Flat Files, CSV- und JSON-Dateien, XML, NoSQL-Systemen, PDFs, Microsoft-Office-Dokumenten, Bildern oder anderen unstrukturierten Datenquellen.
Eine unternehmensweite Datenschutzstrategie sollte solche Informationen deshalb unabhängig vom Speicherort erkennen, klassifizieren und mit einheitlichen Regeln schützen können.
IRI FieldShield konzentriert sich insbesondere auf strukturierte Daten in Datenbanken und Dateien. IRI DarkShield erweitert die Datenmaskierung auf semi-strukturierte und unstrukturierte Daten sowie NoSQL-, Dokument- und Bildformate. Damit können Unternehmen Maskierungsregeln über sehr unterschiedliche Datenlandschaften hinweg konsistent einsetzen. Beide Produkte und noch weitere Funktionen sind in der End-to-End Datenmanagement-Plattform IRI Voracity enthalten!
Sicherer Datenaustausch zwischen Abteilungen: Banken und Versicherungen arbeiten meist mit stark verteilten IT- und Organisationsstrukturen. Daten werden beispielsweise für Risikoanalysen, Betrugserkennung, Kundenanalysen, Reporting oder Entwicklung zwischen verschiedenen Bereichen ausgetauscht.
Nicht jeder Mitarbeiter und nicht jedes System benötigt dabei Zugriff auf vollständige Kundeninformationen. Durch rollenbasierte oder dynamische Datenmaskierung können sensible Daten abhängig von Benutzer, Rolle oder Anwendung unterschiedlich dargestellt werden.
So kann beispielsweise eine Anwendung nur die letzten Stellen einer Kreditkartennummer anzeigen, während autorisierte Systeme weiterhin auf die benötigten Informationen zugreifen können.
Daten sicher an Dienstleister und Partner weitergeben: Finanzunternehmen arbeiten regelmäßig mit externen IT-Dienstleistern, Softwareentwicklern, Callcentern, Analyseunternehmen oder anderen Partnern zusammen. Je mehr Originaldaten die eigene kontrollierte Infrastruktur verlassen, desto größer wird die potenzielle Angriffsfläche.
Eine wirkungsvolle Strategie besteht daher darin, personenbezogene oder vertrauliche Informationen bereits vor der Weitergabe zu maskieren oder zu pseudonymisieren. Externe Partner erhalten dadurch nur diejenigen Informationen, die sie für ihre Aufgabe tatsächlich benötigen.
Dieses Prinzip unterstützt zugleich Konzepte wie Data Minimization, Least Privilege und Privacy by Design.
DSGVO, DORA und Data Governance: Datenmaskierung kann einen wichtigen Beitrag zu einer umfassenden Datenschutz- und Data-Governance-Strategie leisten.
Die DSGVO nennt Pseudonymisierung als mögliche technische und organisatorische Schutzmaßnahme. Pseudonymisierte Informationen bleiben jedoch personenbezogene Daten, wenn eine Zuordnung zu einer Person mit zusätzlichen Informationen weiterhin möglich ist.
Datenmaskierung ersetzt daher keine Datenschutzstrategie, sondern ergänzt Zugriffskontrollen, Verschlüsselung, Berechtigungskonzepte und organisatorische Maßnahmen.
Für Banken, Versicherungen und andere Finanzunternehmen gewinnt zusätzlich DORA – Digital Operational Resilience Act an Bedeutung. Dabei stehen unter anderem IKT-Risikomanagement, operative Widerstandsfähigkeit und Risiken durch externe IT-Dienstleister im Mittelpunkt.
Eine konsequente Datenmaskierung kann helfen, die Auswirkungen eines unberechtigten Datenzugriffs zu reduzieren, weil sensible Originalwerte in vielen nichtproduktiven oder externen Umgebungen gar nicht mehr vorhanden sind.
Sensible Daten für Cloud, Data Lakes und KI schützen: Cloud-Plattformen, Data Lakes, Machine Learning und generative KI eröffnen auch Finanzunternehmen neue Möglichkeiten für Analysen und Automatisierung.
Gleichzeitig stellt sich eine zentrale Frage: Wie können sensible Finanz- und Kundendaten für KI und Analytics genutzt werden, ohne unnötig personenbezogene Originaldaten bereitzustellen? Datenmaskierung, Pseudonymisierung und synthetische Testdaten bieten hierfür wichtige Ansätze.
Sensible Informationen können beispielsweise bereits vor der Migration in eine Cloud- oder KI-Umgebung geschützt werden. Analyse-, Entwicklungs- oder KI-Systeme arbeiten anschließend mit geschützten Daten anstelle realer Kundenidentitäten. Das reduziert die Verbreitung produktiver PII innerhalb komplexer IT-Landschaften.
Datenmaskierung als Bestandteil moderner BFSI-Datensicherheit!
Für Banken, Finanzdienstleister und Versicherungen ist Datenmaskierung heute weit mehr als ein Werkzeug für klassische Testdaten.
Sie unterstützt unter anderem: sichere Softwareentwicklung, DevOps und QA, Cloud-Migrationen, KI- und Machine-Learning-Projekte, Datenanalysen, Zusammenarbeit mit externen Dienstleistern sowie Datenschutz- und Data-Governance-Strategien.
Der entscheidende Ansatz lautet: Sensible Daten sollten nicht nur gegen unbefugten Zugriff geschützt werden. Wo Originalwerte nicht benötigt werden, sollten sie möglichst gar nicht erst offengelegt werden.
Mit IRI Lösungen lassen sich sensible Informationen in unterschiedlichen Datenquellen erkennen, klassifizieren und gezielt maskieren. Damit können Unternehmen im BFSI-Sektor den Nutzen ihrer Daten erhalten und gleichzeitig personenbezogene und vertrauliche Informationen besser schützen.
Datenschutz und Datennutzung müssen kein Widerspruch sein: Moderne Datenmaskierung schafft die Grundlage dafür, Finanzdaten sicher für Entwicklung, Tests, Analytics, Cloud und KI einzusetzen!
Effizienz trifft Erfahrung: Seit mehr als vier Jahrzehnten unterstützen unsere Softwarelösungen Unternehmen bei Datenmanagement und Datenschutz – technologisch führend, zuverlässig im produktiven Einsatz und branchenübergreifend einsetzbar.
Seit 1978 im Einsatz: Zahlreiche namhafte Unternehmen, Dienstleister, Finanzinstitute sowie Landes- und Bundesbehörden zählen zu unseren langjährigen Kunden – nationale Referenzen sind hier gelistet und internationale Referenzen sind hier zusammengefasst.
Maximale Kompatibilität: Unsere Software unterstützt sowohl klassische Mainframe-Plattformen (Fujitsu BS2000/OSD, IBM z/OS, z/VSE, z/Linux) als auch moderne Open-System-Umgebungen wie Linux, UNIX-Derivate und Windows.
Sparen Sie Zeit und Geld bei der Manipulation oder dem Schutz Ihrer Daten mit unserer bewährten Low-Code-Datenmanagement- und Maskierungssoftware. Wir verbinden modernste Technologie mit jahrzehntelanger Erfahrung in der Verarbeitung von Produktionsdaten auf verschiedenen Plattformen und in unterschiedlichen Branchen.
Mit unserer Software können Sie:
Große Sortier- und ETL-Aufträge beschleunigen
Beschleunigung von Datenbank-Entladungen, -Ladungen, -Reorgs und -Abfragen
Konvertieren und Neuformatieren von alten Datentypen, Dateien und Datenbanken
Erstellung benutzerdefinierter Berichte oder Aufbereitung von Daten für Analysen und KI
Ersetzen von alten ETL-, SQL- und Sortieraufträgen
Suchen, Extrahieren und Restrukturieren unstrukturierter Daten
Replizieren und Erfassen geänderter Datenbank-Daten in Echtzeit
Filtern, Bereinigen, Anreichern und Standardisieren von Daten
PII klassifizieren, entdecken und de-identifizieren
Daten statisch, dynamisch oder inkrementell maskieren
PHI-Re-ID-Risiko bewerten und Quasi-Identifikatoren anonymisieren
Synthetisieren von strukturell und referenziell korrekten Testdaten
Profitieren Sie von der Leistungsfähigkeit und Flexibilität der preisgekrönten IRI-Lösungen, die von Analysten beraten und durch 40 Partnerbüros weltweit unterstützt werden. Vermeiden Sie die steile Lernkurve und die hohen Kosten von Multi-Tool- und Mega-Anbieter-Lösungen und entdecken Sie die Vorteile schnellerer Design- und Laufzeiten für Ihr Unternehmen.
Die spezifischen Lösungen sind kompatibel mit allen gängigen Betriebssystemen, vom Mainframe (Fujitsu BS2000/OSD, IBM z/OS und z/VSE + z/Linux) bis hin zu Open Systems (UNIX & Derivate, Linux + Windows).
Seit 1978 weltweit anerkannt im B2B-Sektor: Großunternehmen, nationale und internationale Dienstleister, Privat-, Groß-, Landes- und Bundesbanken, Sozial- und Privatversicherungen sowie deutsche, Landes- und Bundesbehörden!
JET-Software
Edmund-Lang-Straße 16
64832 Babenhausen
Telefon: +49 (6073) 711-403
Telefax: +49 (6073) 711-405
https://www.jet-software.com
Telefon: +49 (6073) 711403
Fax: +49 (6073) 711405
E-Mail: amadeus.thomas@jet-software.com

❌ Informatica-PowerCenter ❌ Alternative für ETL, Datenmaskierung und Testdaten ohne Cloud-Zwang ❗
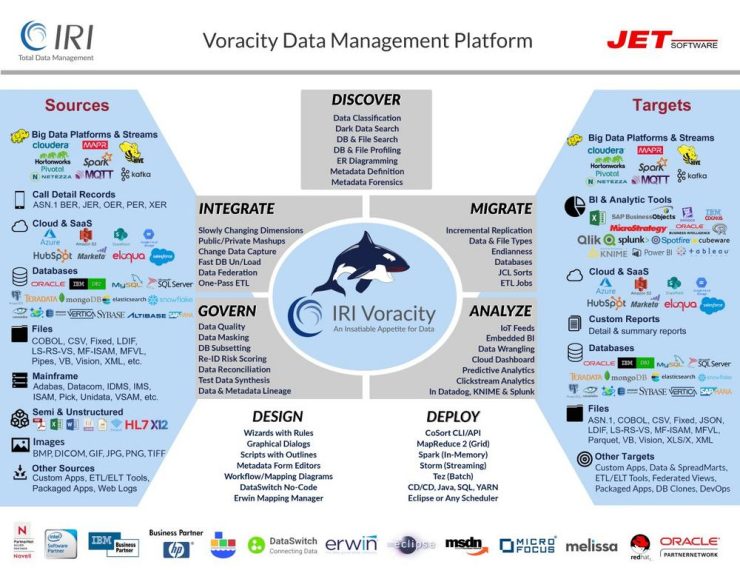
IRI Voracity bietet eine solche Alternative zu Informatica PowerCenter. Die Plattform kombiniert leistungsfähige Datenintegration mit Datenschutz, Datenqualität, Datenmigration und Testdatenmanagement. Dadurch lassen sich mehrere bislang getrennte Werkzeuge in einer zentralen Umgebung zusammenführen.
Warum suchen Unternehmen eine Alternative zu Informatica PowerCenter?
Viele Unternehmen betreiben bewährte Datenprozesse in eigenen Rechenzentren oder kontrollierten IT-Umgebungen. Ein vollständiger Wechsel in die Cloud passt jedoch nicht zu jeder IT-Strategie. Gründe dafür sind unter anderem regulatorische Vorgaben, sensible personenbezogene Daten, bestehende Mainframe- und Legacy-Systeme oder der Wunsch nach digitaler Souveränität.
Eine geeignete Informatica-PowerCenter-Alternative sollte deshalb nicht nur ETL-Prozesse ersetzen. Sie muss vorhandene Datenquellen integrieren, große Datenmengen performant verarbeiten und gleichzeitig Datenschutz- und Governance-Anforderungen erfüllen.
ETL und Datenmaskierung in einem Prozess!
IRI Voracity verarbeitet Daten nach einem leistungsfähigen Single-Pass-Ansatz. Daten können innerhalb eines Workflows unter anderem:
– extrahiert und transformiert,
– sortiert, gefiltert und zusammengeführt,
– bereinigt und standardisiert,
– migriert und neu formatiert,
– klassifiziert und maskiert sowie
– für Tests, Analysen und KI-Anwendungen aufbereitet werden.
Personenbezogene und andere sensible Informationen lassen sich während der Verarbeitung beispielsweise pseudonymisieren, verschlüsseln, tokenisieren oder durch realistische Ersatzwerte maskieren. Damit werden ETL und Data Masking nicht als getrennte Aufgaben behandelt.
Testdaten für Entwicklung, Qualitätssicherung und DevOps: Neben der Maskierung vorhandener Produktionsdaten unterstützt Voracity auch die Erstellung synthetischer Testdaten. Struktur, Datenformate und referenzielle Beziehungen können dabei erhalten beziehungsweise gezielt nachgebildet werden.
Entwicklungs- und Testteams erhalten realistische Datenbestände, ohne produktive personenbezogene Daten unnötig offenzulegen. Die erzeugten oder maskierten Testdaten lassen sich außerdem in automatisierte DevOps- und CI/CD-Prozesse integrieren.
Welche Funktionen bietet IRI Voracity?
Die Plattform deckt zentrale Bereiche des Data Lifecycle Managements ab:
1. Data Discovery und Klassifizierung sensibler Daten
2. ETL, Datenintegration, CDC und Datenmigration
3. statische, dynamische und inkrementelle Datenmaskierung
4. synthetische und referenziell korrekte Testdaten
5. Datenqualität, Bereinigung und Standardisierung
6. Unterstützung von Governance- und Compliance-Prozessen
7. Aufbereitung von Daten für BI, Analytics und KI
Die Eclipse-basierte IRI Workbench stellt dafür eine einheitliche grafische Entwicklungsumgebung bereit. Unterstützt werden Windows, Linux und verschiedene UNIX-Plattformen sowie klassische Mainframe-Umgebungen.
Mehr Datenhoheit und weniger Werkzeugkomplexität: Wer für ETL, Datenmaskierung, Testdaten und Datenqualität verschiedene Produkte einsetzt, muss zahlreiche Schnittstellen, Lizenzmodelle und Betriebsprozesse verwalten. Eine integrierte Plattform kann diese Komplexität reduzieren und die Umsetzung durchgängiger Datenprozesse vereinfachen.
IRI Voracity ermöglicht Unternehmen, ihre bestehende On-Premises-Strategie fortzuführen und gleichzeitig moderne Anforderungen an Datenschutz, Testdatenmanagement und Data Governance abzudecken. Die Plattform ist damit nicht nur ein möglicher Ersatz für Informatica PowerCenter, sondern eine umfassendere Lösung für die kontrollierte Verarbeitung und den Schutz großer Datenmengen.
Effizienz trifft Erfahrung: Seit mehr als vier Jahrzehnten unterstützen unsere Softwarelösungen Unternehmen bei Datenmanagement und Datenschutz – technologisch führend, zuverlässig im produktiven Einsatz und branchenübergreifend einsetzbar.
Seit 1978 im Einsatz: Zahlreiche namhafte Unternehmen, Dienstleister, Finanzinstitute sowie Landes- und Bundesbehörden zählen zu unseren langjährigen Kunden – nationale Referenzen sind hier gelistet und internationale Referenzen sind hier zusammengefasst.
Maximale Kompatibilität: Unsere Software unterstützt sowohl klassische Mainframe-Plattformen (Fujitsu BS2000/OSD, IBM z/OS, z/VSE, z/Linux) als auch moderne Open-System-Umgebungen wie Linux, UNIX-Derivate und Windows.
Sparen Sie Zeit und Geld bei der Manipulation oder dem Schutz Ihrer Daten mit unserer bewährten Low-Code-Datenmanagement- und Maskierungssoftware. Wir verbinden modernste Technologie mit jahrzehntelanger Erfahrung in der Verarbeitung von Produktionsdaten auf verschiedenen Plattformen und in unterschiedlichen Branchen.
Mit unserer Software können Sie:
Große Sortier- und ETL-Aufträge beschleunigen
Beschleunigung von Datenbank-Entladungen, -Ladungen, -Reorgs und -Abfragen
Konvertieren und Neuformatieren von alten Datentypen, Dateien und Datenbanken
Erstellung benutzerdefinierter Berichte oder Aufbereitung von Daten für Analysen und KI
Ersetzen von alten ETL-, SQL- und Sortieraufträgen
Suchen, Extrahieren und Restrukturieren unstrukturierter Daten
Replizieren und Erfassen geänderter Datenbank-Daten in Echtzeit
Filtern, Bereinigen, Anreichern und Standardisieren von Daten
PII klassifizieren, entdecken und de-identifizieren
Daten statisch, dynamisch oder inkrementell maskieren
PHI-Re-ID-Risiko bewerten und Quasi-Identifikatoren anonymisieren
Synthetisieren von strukturell und referenziell korrekten Testdaten
Profitieren Sie von der Leistungsfähigkeit und Flexibilität der preisgekrönten IRI-Lösungen, die von Analysten beraten und durch 40 Partnerbüros weltweit unterstützt werden. Vermeiden Sie die steile Lernkurve und die hohen Kosten von Multi-Tool- und Mega-Anbieter-Lösungen und entdecken Sie die Vorteile schnellerer Design- und Laufzeiten für Ihr Unternehmen.
Die spezifischen Lösungen sind kompatibel mit allen gängigen Betriebssystemen, vom Mainframe (Fujitsu BS2000/OSD, IBM z/OS und z/VSE + z/Linux) bis hin zu Open Systems (UNIX & Derivate, Linux + Windows).
Seit 1978 weltweit anerkannt im B2B-Sektor: Großunternehmen, nationale und internationale Dienstleister, Privat-, Groß-, Landes- und Bundesbanken, Sozial- und Privatversicherungen sowie deutsche, Landes- und Bundesbehörden!
JET-Software
Edmund-Lang-Straße 16
64832 Babenhausen
Telefon: +49 (6073) 711-403
Telefax: +49 (6073) 711-405
https://www.jet-software.com
Telefon: +49 (6073) 711403
Fax: +49 (6073) 711405
E-Mail: amadeus.thomas@jet-software.com

❌ DSGVO-konforme KI ❌ Personenbezogene Daten für KI-Modelle und LLMs sicher maskieren ❗
Künstliche Intelligenz und Large Language Models (LLMs) benötigen große und aussagekräftige Datenmengen. Doch Unternehmensdaten enthalten häufig personenbezogene Informationen wie Namen, Adressen, Kontaktdaten, Kontonummern, Gesundheitsinformationen oder andere sensible Inhalte. Werden solche Daten ungeprüft für KI-Training, Retrieval-Augmented Generation (RAG), Tests oder Analysen verwendet, können erhebliche Datenschutz- und Compliance-Risiken entstehen.
Datenmaskierung schafft die technische Grundlage, um sensible Informationen zu schützen und Daten gleichzeitig für KI-Anwendungen nutzbar zu halten. Personenbezogene Daten werden dabei erkannt, klassifiziert und durch geeignete Verfahren geschützt, bevor sie an ein KI-Modell, eine Analyseplattform oder einen externen Dienst übergeben werden.
Warum müssen personenbezogene Daten vor der KI-Nutzung geschützt werden?
KI-Systeme verarbeiten Informationen aus Datenbanken, Dokumenten, E-Mails, PDF-Dateien, Bildern, Cloud-Speichern und zahlreichen weiteren Quellen. Gerade in unstrukturierten Datenbeständen können personenbezogene Informationen unbemerkt enthalten sein.
Ein wirksames Datenschutzkonzept sollte deshalb bereits vor dem Training oder der Verarbeitung durch ein KI-System ansetzen. Sensible Daten werden zunächst automatisiert gesucht und klassifiziert. Anschließend können sie entsprechend festgelegter Datenschutzregeln maskiert, pseudonymisiert, verschlüsselt, ersetzt oder entfernt werden.
So lässt sich das Risiko reduzieren, dass personenbezogene Informationen in Trainingsdaten, Prompts, Vektordatenbanken, Modellergebnissen oder Testumgebungen offengelegt werden.
Welche Verfahren schützen Daten für KI und LLMs?
Je nach Datenart, Verwendungszweck und Schutzbedarf kommen unterschiedliche Methoden infrage:
- Pseudonymisierung: Direkte Identifikatoren werden durch konsistente Ersatzwerte ersetzt. Zusammengehörige Datensätze und Beziehungen können erhalten bleiben.
- Tokenisierung: Sensible Originalwerte werden gegen kontrollierte Token ausgetauscht.
- Formaterhaltende Verschlüsselung (FPE): Werte werden geschützt, behalten jedoch ihr ursprüngliches Format und können deshalb in bestehenden Anwendungen weiterverarbeitet werden.
- Redaktion und Anonymisierung: Personenbezogene Inhalte werden vollständig entfernt oder so verändert, dass eine Identifizierung verhindert werden soll.
- Synthetische Daten: Künstlich erzeugte Datensätze bilden benötigte Strukturen, Regeln und Verteilungen ab, ohne reale personenbezogene Ausgangsdaten direkt zu verwenden.
Pseudonymisierte Daten gelten allerdings grundsätzlich weiterhin als personenbezogene Daten. Ob eine Verarbeitung die Anforderungen der DSGVO erfüllt, hängt deshalb auch vom konkreten Anwendungsfall, den technischen und organisatorischen Maßnahmen sowie der möglichen Reidentifizierung ab.
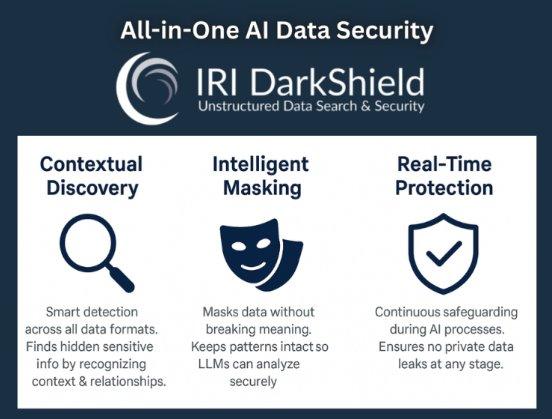
IRI DarkShield erkennt und maskiert sensible KI-Daten!
Mit IRI DarkShield lassen sich personenbezogene und andere sensible Informationen in strukturierten, semistrukturierten und unstrukturierten Datenbeständen suchen, klassifizieren und maskieren. Dazu gehören unter anderem:
- Text-, PDF- und Microsoft-Office-Dokumente
- JSON-, XML-, EDI- und Parquet-Dateien
- relationale Datenbanken und NoSQL-Datenbanken
- Bilder und medizinische Dokumente
- lokale Speicherorte und Cloud-Umgebungen
Suchregeln, reguläre Ausdrücke, Wörterbücher und Machine-Learning-Verfahren helfen dabei, relevante PII- und PHI-Daten zu identifizieren. Die gefundenen Informationen können anschließend regelbasiert de-identifiziert werden. Dadurch eignet sich DarkShield besonders für Datenbestände, die für generative KI, RAG-Systeme, LLMs oder andere Machine-Learning-Anwendungen vorbereitet werden sollen.
Synthetische Daten für datenschutzgerechtes KI-Training!
Wenn reale Produktionsdaten nicht verwendet werden sollen, bietet IRI RowGen eine zusätzliche Möglichkeit: die Erzeugung synthetischer Test- und Trainingsdaten.
Dabei können Datenformate, Wertebereiche, Abhängigkeiten, Verteilungen und referenzielle Beziehungen gezielt nachgebildet werden. Unternehmen erhalten realistische Datensätze für Entwicklung, Qualitätssicherung, Analysen und KI-Projekte, ohne sensible Originalinformationen direkt bereitzustellen.
Datenmaskierung und synthetische Datengenerierung lassen sich außerdem kombinieren. So können geeignete Teile vorhandener Daten geschützt übernommen und fehlende oder besonders kritische Informationen synthetisch ergänzt werden.
Bleibt die Datenqualität für KI-Modelle erhalten?
Geeignete Maskierungsverfahren schützen personenbezogene Merkmale, während relevante Strukturen, Formate und statistische Eigenschaften weitgehend erhalten bleiben können. Welche Methode optimal ist, hängt vom Trainingsziel und von den benötigten Datenbeziehungen ab.
Daher sollte nach jeder Maskierung oder Datensynthese geprüft werden, ob die Daten weiterhin repräsentativ sind und das gewünschte KI-Modell zuverlässige Ergebnisse liefert. Datenschutz und Datenqualität müssen gemeinsam betrachtet werden.
Datenschutzgerechte KI als kontrollierter Prozess!
Eine sichere KI-Strategie beginnt nicht erst beim Modell, sondern bereits bei der Auswahl und Vorbereitung der Daten. Ein kontrollierter Prozess umfasst:
- Datenquellen identifizieren
- Personenbezogene und sensible Daten erkennen
- Informationen klassifizieren
- Geeignete Schutzverfahren anwenden
- Ergebnisse dokumentieren und überprüfen
- Nur freigegebene Daten an KI-Systeme übergeben
Mit IRI DarkShield für die Suche und Maskierung sensibler Informationen sowie IRI RowGen für die Erzeugung synthetischer Daten können Unternehmen Datenschutz frühzeitig in ihre KI-Prozesse integrieren. Dies verbessert die Kontrolle, Nachvollziehbarkeit und Auditierbarkeit und unterstützt einen verantwortungsvollen Einsatz von KI.
Effizienz trifft Erfahrung: Seit mehr als vier Jahrzehnten unterstützen unsere Softwarelösungen Unternehmen bei Datenmanagement und Datenschutz – technologisch führend, zuverlässig im produktiven Einsatz und branchenübergreifend einsetzbar.
Seit 1978 im Einsatz: Zahlreiche namhafte Unternehmen, Dienstleister, Finanzinstitute sowie Landes- und Bundesbehörden zählen zu unseren langjährigen Kunden – nationale Referenzen sind hier gelistet und internationale Referenzen sind hier zusammengefasst.
Maximale Kompatibilität: Unsere Software unterstützt sowohl klassische Mainframe-Plattformen (Fujitsu BS2000/OSD, IBM z/OS, z/VSE, z/Linux) als auch moderne Open-System-Umgebungen wie Linux, UNIX-Derivate und Windows.
Sparen Sie Zeit und Geld bei der Manipulation oder dem Schutz Ihrer Daten mit unserer bewährten Low-Code-Datenmanagement- und Maskierungssoftware. Wir verbinden modernste Technologie mit jahrzehntelanger Erfahrung in der Verarbeitung von Produktionsdaten auf verschiedenen Plattformen und in unterschiedlichen Branchen.
Mit unserer Software können Sie:
Große Sortier- und ETL-Aufträge beschleunigen
Beschleunigung von Datenbank-Entladungen, -Ladungen, -Reorgs und -Abfragen
Konvertieren und Neuformatieren von alten Datentypen, Dateien und Datenbanken
Erstellung benutzerdefinierter Berichte oder Aufbereitung von Daten für Analysen und KI
Ersetzen von alten ETL-, SQL- und Sortieraufträgen
Suchen, Extrahieren und Restrukturieren unstrukturierter Daten
Replizieren und Erfassen geänderter Datenbank-Daten in Echtzeit
Filtern, Bereinigen, Anreichern und Standardisieren von Daten
PII klassifizieren, entdecken und de-identifizieren
Daten statisch, dynamisch oder inkrementell maskieren
PHI-Re-ID-Risiko bewerten und Quasi-Identifikatoren anonymisieren
Synthetisieren von strukturell und referenziell korrekten Testdaten
Profitieren Sie von der Leistungsfähigkeit und Flexibilität der preisgekrönten IRI-Lösungen, die von Analysten beraten und durch 40 Partnerbüros weltweit unterstützt werden. Vermeiden Sie die steile Lernkurve und die hohen Kosten von Multi-Tool- und Mega-Anbieter-Lösungen und entdecken Sie die Vorteile schnellerer Design- und Laufzeiten für Ihr Unternehmen.
Die spezifischen Lösungen sind kompatibel mit allen gängigen Betriebssystemen, vom Mainframe (Fujitsu BS2000/OSD, IBM z/OS und z/VSE + z/Linux) bis hin zu Open Systems (UNIX & Derivate, Linux + Windows).
Seit 1978 weltweit anerkannt im B2B-Sektor: Großunternehmen, nationale und internationale Dienstleister, Privat-, Groß-, Landes- und Bundesbanken, Sozial- und Privatversicherungen sowie deutsche, Landes- und Bundesbehörden!
JET-Software
Edmund-Lang-Straße 16
64832 Babenhausen
Telefon: +49 (6073) 711-403
Telefax: +49 (6073) 711-405
https://www.jet-software.com
Telefon: +49 (6073) 711403
Fax: +49 (6073) 711405
E-Mail: amadeus.thomas@jet-software.com

❌ MS SQL Server schützen ❌ Datenänderungen erkennen, maskieren und sicher weiterverarbeiten ❗
Microsoft SQL Server ist in vielen Unternehmen eine zentrale Datenplattform für geschäftskritische Anwendungen, Data Warehouses und operative Prozesse. Entsprechend häufig werden dort sensible Informationen gespeichert – etwa personenbezogene Daten, Kundendaten, Vertragsinformationen oder Finanzdaten. Klassische Schutzmaßnahmen wie Berechtigungen, Verschlüsselung und Netzwerkabsicherung sind weiterhin wichtig, reichen allein aber nicht immer aus.
Besonders relevant wird der Datenschutz, wenn produktive Daten repliziert, für Analysezwecke bereitgestellt, in Test- und Entwicklungsumgebungen übernommen oder innerhalb von ETL- und Integrationsprozessen weiterverarbeitet werden. Genau hier kann die Kombination aus Change Data Capture (CDC), Datentransformation und Datenmaskierung ansetzen.
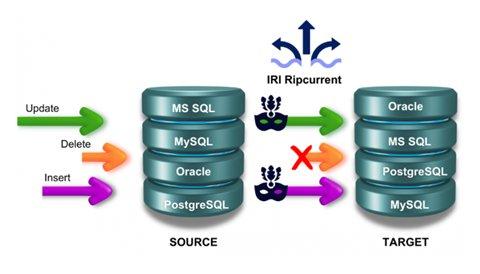
Nur relevante Änderungen erfassen statt komplette Datenbestände neu zu verarbeiten: In produktiven Microsoft SQL Server-Datenbanken ändern sich Daten laufend. Neue Datensätze entstehen, bestehende werden aktualisiert oder gelöscht. Müssen diese Änderungen für Data Warehouses, Replikation, Analytics oder andere Zielsysteme übernommen werden, ist eine vollständige Verarbeitung großer Tabellen oft unnötig. Change Data Capture konzentriert sich stattdessen gezielt auf die tatsächlich erfolgten Änderungen!
Mit IRI Ripcurrent lassen sich Änderungen in Microsoft SQL Server sowie weiteren unterstützten relationalen Datenbanken erkennen. Neue, geänderte und gelöschte Datensätze können dadurch identifiziert und für nachgelagerte Prozesse bereitgestellt werden. Der Vorteil liegt auf der Hand: Statt komplette Datenbestände immer wieder neu zu bewegen, werden nur die relevanten Änderungen verarbeitet.
CDC und Datenmaskierung intelligent miteinander verbinden!
Besonders interessant wird Change Data Capture, wenn die erkannten Änderungen nicht nur repliziert, sondern direkt weiterverarbeitet werden.
Je nach Anforderung können die Daten dabei beispielsweise:
- maskiert oder pseudonymisiert,
- verschlüsselt,
- bereinigt,
- gefiltert,
- transformiert,
- konvertiert,
- aggregiert oder
- für unterschiedliche Zielsysteme vorbereitet werden.
So können neue oder geänderte SQL-Server-Datensätze erkannt und sensible Felder bereits während der Weitergabe an andere Systeme geschützt werden. Produktive Daten müssen dadurch nicht automatisch im Klartext in Testsysteme, Data Warehouses, Analyseplattformen oder weitere Zielumgebungen gelangen.
Datenschutz direkt in die Datenbewegung integrieren!
In vielen klassischen Datenprozessen werden Informationen zunächst extrahiert oder repliziert und erst anschließend in einem zusätzlichen Schritt maskiert. Durch eine integrierte Verarbeitung lässt sich dieser Ablauf effizienter gestalten. Werden CDC, Transformation und Datenmaskierung miteinander kombiniert, kann der Datenschutz bereits während der Datenbewegung berücksichtigt werden.
Ein typisches Beispiel: Eine Microsoft-SQL-Server-Anwendung enthält Kundendaten wie Name, Adresse, Telefonnummer oder Kontoinformationen. Für eine Analyseplattform werden bestimmte Änderungen nahezu in Echtzeit benötigt.
IRI Ripcurrent erkennt die relevanten Datensatzänderungen. Während der anschließenden Verarbeitung können sensible Informationen pseudonymisiert oder maskiert werden, bevor sie das Zielsystem erreichen. Die benötigte Datenstruktur bleibt erhalten, während gleichzeitig die Offenlegung personenbezogener Daten reduziert wird.
Einsatzmöglichkeiten für Analytics, DevOps und Testsysteme: Gerade außerhalb produktiver Systeme besteht häufig ein erhöhtes Risiko, dass sensible Informationen unnötig offengelegt werden. Entwicklungs-, Test-, Reporting- oder Analyseumgebungen benötigen zwar realistische Daten, jedoch meist nicht die tatsächlichen Identitäten der betroffenen Personen.
Durch die Kombination von Microsoft SQL Server CDC und Datenmaskierung können kontinuierlich aktualisierte Test- oder Analysebestände erzeugt werden, ohne jede Änderung ungeschützt zu replizieren.
Typische Einsatzbereiche sind:
1. Data Warehousing und Business Intelligence: Nur relevante Änderungen werden übernommen und direkt für Reporting und Analytics aufbereitet.
2. Test- und Entwicklungsumgebungen: Produktive Änderungen können maskiert bereitgestellt werden, bevor Entwickler oder Tester darauf zugreifen.
3. Datenreplikation: SQL-Server-Daten lassen sich inkrementell an andere relationale Datenbanken oder Plattformen übertragen.
4. Cloud- und Hybrid-Architekturen: Sensible Informationen können geschützt werden, bevor sie die ursprüngliche Systemumgebung verlassen.
5. ETL- und Datenintegrationsprozesse: CDC kann mit Transformation, Datenqualität, Konvertierung und Datenmaskierung kombiniert werden.
Deltas auch ohne klassische Echtzeit-CDC erkennen!
Nicht jedes Szenario erfordert eine permanente Echtzeitüberwachung. Mit SortCL, der Datenverarbeitungsengine von IRI CoSort und IRI Voracity, können auch große Tabellen, Dateien und andere Datenquellen miteinander verglichen werden. Auf diese Weise lassen sich Inserts, Updates und Deletes ebenfalls als Deltas identifizieren.
Dieser Ansatz eignet sich insbesondere dann, wenn Änderungen zwischen unterschiedlichen Datenquellen analysiert oder gleichzeitig komplexere Transformationen durchgeführt werden sollen. Die erkannten Deltas können anschließend direkt weiterverarbeitet werden – etwa durch Bereinigung, Konvertierung, Aggregation, Reporting oder Datenmaskierung. Damit stehen unterschiedliche Ansätze zur Verfügung: von der kontinuierlichen Erfassung von Datenbankänderungen bis zum gezielten Vergleich großer Datenbestände.
MS SQL Server-Daten schützen und Datenprozesse effizient halten:
Datenschutz und Datenintegration müssen nicht getrennt voneinander betrachtet werden. Die Kombination aus Microsoft SQL Server Change Data Capture, Datenreplikation, Transformation und Datenmaskierung ermöglicht es, relevante Änderungen gezielt zu erfassen und sensible Daten bereits vor der Übergabe an nachgelagerte Systeme zu schützen.
Statt komplette Datenbestände regelmäßig neu zu kopieren und anschließend separat abzusichern, können Datenänderungen direkt verarbeitet und geschützt werden. So entsteht ein moderner Datenfluss, bei dem Performance, Datenintegration und Datenschutz gemeinsam berücksichtigt werden. Gerade in datenintensiven Microsoft-SQL-Server-Umgebungen kann dieser Ansatz dazu beitragen, ETL- und Replikationsprozesse effizienter zu gestalten und gleichzeitig unnötige Klartextkopien sensibler Daten zu vermeiden.
Effizienz trifft Erfahrung: Seit mehr als vier Jahrzehnten unterstützen unsere Softwarelösungen Unternehmen bei Datenmanagement und Datenschutz – technologisch führend, zuverlässig im produktiven Einsatz und branchenübergreifend einsetzbar.
Seit 1978 im Einsatz: Zahlreiche namhafte Unternehmen, Dienstleister, Finanzinstitute sowie Landes- und Bundesbehörden zählen zu unseren langjährigen Kunden – nationale Referenzen sind hier gelistet und internationale Referenzen sind hier zusammengefasst.
Maximale Kompatibilität: Unsere Software unterstützt sowohl klassische Mainframe-Plattformen (Fujitsu BS2000/OSD, IBM z/OS, z/VSE, z/Linux) als auch moderne Open-System-Umgebungen wie Linux, UNIX-Derivate und Windows.
Sparen Sie Zeit und Geld bei der Manipulation oder dem Schutz Ihrer Daten mit unserer bewährten Low-Code-Datenmanagement- und Maskierungssoftware. Wir verbinden modernste Technologie mit jahrzehntelanger Erfahrung in der Verarbeitung von Produktionsdaten auf verschiedenen Plattformen und in unterschiedlichen Branchen.
Mit unserer Software können Sie:
Große Sortier- und ETL-Aufträge beschleunigen
Beschleunigung von Datenbank-Entladungen, -Ladungen, -Reorgs und -Abfragen
Konvertieren und Neuformatieren von alten Datentypen, Dateien und Datenbanken
Erstellung benutzerdefinierter Berichte oder Aufbereitung von Daten für Analysen und KI
Ersetzen von alten ETL-, SQL- und Sortieraufträgen
Suchen, Extrahieren und Restrukturieren unstrukturierter Daten
Replizieren und Erfassen geänderter Datenbank-Daten in Echtzeit
Filtern, Bereinigen, Anreichern und Standardisieren von Daten
PII klassifizieren, entdecken und de-identifizieren
Daten statisch, dynamisch oder inkrementell maskieren
PHI-Re-ID-Risiko bewerten und Quasi-Identifikatoren anonymisieren
Synthetisieren von strukturell und referenziell korrekten Testdaten
Profitieren Sie von der Leistungsfähigkeit und Flexibilität der preisgekrönten IRI-Lösungen, die von Analysten beraten und durch 40 Partnerbüros weltweit unterstützt werden. Vermeiden Sie die steile Lernkurve und die hohen Kosten von Multi-Tool- und Mega-Anbieter-Lösungen und entdecken Sie die Vorteile schnellerer Design- und Laufzeiten für Ihr Unternehmen.
Die spezifischen Lösungen sind kompatibel mit allen gängigen Betriebssystemen, vom Mainframe (Fujitsu BS2000/OSD, IBM z/OS und z/VSE + z/Linux) bis hin zu Open Systems (UNIX & Derivate, Linux + Windows).
Seit 1978 weltweit anerkannt im B2B-Sektor: Großunternehmen, nationale und internationale Dienstleister, Privat-, Groß-, Landes- und Bundesbanken, Sozial- und Privatversicherungen sowie deutsche, Landes- und Bundesbehörden!
JET-Software
Edmund-Lang-Straße 16
64832 Babenhausen
Telefon: +49 (6073) 711-403
Telefax: +49 (6073) 711-405
https://www.jet-software.com
Telefon: +49 (6073) 711403
Fax: +49 (6073) 711405
E-Mail: amadeus.thomas@jet-software.com

❌ PostgreSQL optimieren ❌ High-Speed-ETL, Datenmigration und sichere Datenmaskierung ❗
PostgreSQL gehört zu den wichtigsten relationalen Open-Source-Datenbanken und wird sowohl für klassische Geschäftsanwendungen als auch für moderne Datenplattformen eingesetzt. Mit wachsenden Datenmengen steigen jedoch die Anforderungen an Performance, Datenintegration und Datenschutz. Umfangreiche ETL-Prozesse, komplexe Transformationen und die sichere Bereitstellung von Daten für Entwicklung, Tests oder Analysen können bestehende Systeme zunehmend belasten.
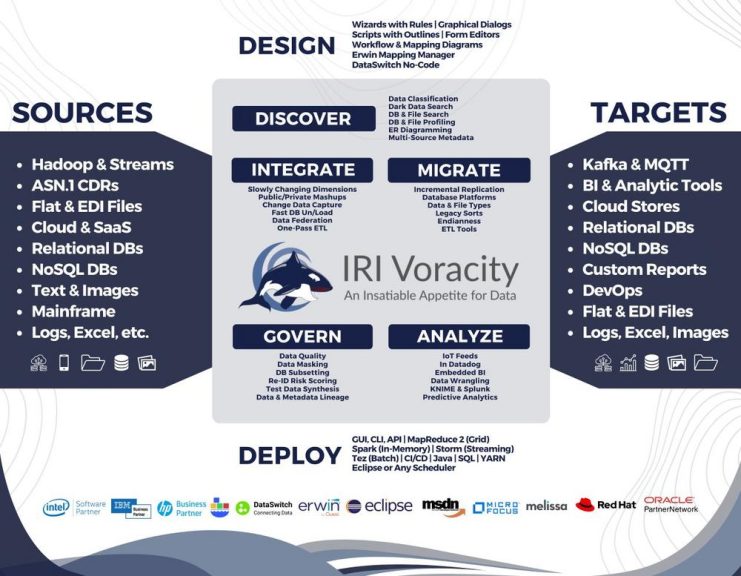
Die IRI-Lösungen verbinden schnelle PostgreSQL-Datenverarbeitung mit integrierter Datenmaskierung, Datenmigration und Datenqualität. Unternehmen können große Datenbestände effizient extrahieren, transformieren, bereinigen und schützen – ohne für jede Aufgabe ein separates Werkzeug einsetzen zu müssen.
PostgreSQL-ETL schneller und effizienter gestalten: Zeitaufwendige Sortierungen, Joins, Aggregationen und Transformationen können aus der Datenbank ausgelagert und mit der leistungsstarken IRI CoSort Engine verarbeitet werden. Dadurch lassen sich umfangreiche PostgreSQL-ETL-Prozesse beschleunigen und Datenbankressourcen gezielter nutzen.
Mehrere Arbeitsschritte können innerhalb eines gemeinsamen Datenflusses ausgeführt werden. Daten lassen sich beispielsweise gleichzeitig:
- filtern und sortieren,
- zusammenführen und aggregieren,
- bereinigen und standardisieren,
- konvertieren und neu formatieren,
- maskieren und für Zielsysteme bereitstellen.
Die Verarbeitung erfolgt über die Eclipse-basierte IRI Workbench. Sie bietet eine zentrale grafische Umgebung für die Entwicklung, Ausführung und Verwaltung von Datenintegrations-, Migrations- und Datenschutzaufgaben.
Personenbezogene PostgreSQL-Daten wirksam maskieren: PostgreSQL-Datenbanken enthalten häufig personenbezogene oder andere sensible Informationen wie Namen, Adressen, Kundennummern, Kontodaten oder Gesundheitsinformationen. Werden produktive Daten für Entwicklung, Softwaretests, Schulungen oder externe Analysen kopiert, entsteht ein erhebliches Datenschutzrisiko.
Mit IRI FieldShield und IRI Voracity können sensible Daten in PostgreSQL automatisch gefunden, klassifiziert und regelbasiert maskiert werden. Dafür stehen unter anderem Pseudonymisierung, Tokenisierung, Verschlüsselung, Hashing, Schwärzung und Format-preserving Encryption zur Verfügung.
Die Daten bleiben strukturell und funktional verwendbar, während reale Identitäten geschützt werden. Konsistente Maskierungsregeln sorgen außerdem dafür, dass Beziehungen zwischen Tabellen und Anwendungen erhalten bleiben. So können realistische Test- und Analysedaten bereitgestellt werden, ohne unnötig personenbezogene Originaldaten offenzulegen.
ETL und Datenschutz in einem Prozess verbinden: Ein entscheidender Vorteil liegt in der Verbindung von Datenintegration und Datenschutz. Sensible Informationen müssen nicht erst exportiert, anschließend mit einem weiteren Produkt geschützt und danach erneut geladen werden. Transformation, Bereinigung und Datenmaskierung können direkt im selben Verarbeitungsschritt erfolgen.
Das reduziert zusätzliche Datenbewegungen, vereinfacht die Administration und unterstützt die Einhaltung von DSGVO- sowie internen Compliance-Vorgaben. Gleichzeitig sinkt das Risiko, dass ungeschützte Kopien in Zwischenverzeichnissen, Testsystemen oder Analyseumgebungen zurückbleiben.
PostgreSQL-Daten migrieren und modernisieren: Auch bei Datenbankmigrationen und Modernisierungsprojekten unterstützen die IRI-Werkzeuge den sicheren Wechsel zwischen unterschiedlichen Plattformen, Datenbanken, Dateien und Datentypen. Bestehende PostgreSQL-Daten können extrahiert, neu strukturiert, konvertiert und in das gewünschte Zielsystem übertragen werden.
Die Funktionen stehen nicht nur für native PostgreSQL-Datenbanken zur Verfügung. Unterstützt werden laut JET-Software auch PostgreSQL-kompatible Systeme wie Amazon Aurora, Amazon Redshift, CockroachDB, EnterpriseDB und Yellowbrick. Damit eignen sich die Lösungen sowohl für lokale Rechenzentren als auch für hybride und cloudbasierte Datenarchitekturen.
Eine Plattform für den gesamten Datenlebenszyklus: IRI Voracity bündelt zentrale Aufgaben des modernen Datenmanagements in einer gemeinsamen Low-Code-Plattform. Dazu gehören Data Discovery, Datenprofilierung, ETL, Datenmigration, Datenqualität, Datenmaskierung, Testdatenmanagement und Data Governance.
Anstelle komplexer Multi-Tool-Umgebungen entsteht ein durchgängiger Arbeitsablauf: PostgreSQL-Daten werden erkannt, verarbeitet, geschützt und für nachgelagerte Anwendungen bereitgestellt. Unternehmen gewinnen dadurch mehr Transparenz und Kontrolle über ihre Datenprozesse.
Fazit: Leistungsfähige PostgreSQL-Umgebungen benötigen mehr als eine schnelle Datenbank. Erst das Zusammenspiel aus High-Speed-ETL, Datenqualität, sicherer Datenmigration und konsequenter Datenmaskierung ermöglicht effiziente und datenschutzgerechte Prozesse.
Die IRI-Lösungen kombinieren diese Aufgaben in einer zentralen Umgebung. So lassen sich große PostgreSQL-Datenbestände schneller verarbeiten, sensible Informationen zuverlässig schützen und Daten sicher für Entwicklung, Tests, Analysen oder neue Plattformen bereitstellen.
Effizienz trifft Erfahrung: Seit mehr als vier Jahrzehnten unterstützen unsere Softwarelösungen Unternehmen bei Datenmanagement und Datenschutz – technologisch führend, zuverlässig im produktiven Einsatz und branchenübergreifend einsetzbar.
Seit 1978 im Einsatz: Zahlreiche namhafte Unternehmen, Dienstleister, Finanzinstitute sowie Landes- und Bundesbehörden zählen zu unseren langjährigen Kunden – nationale Referenzen sind hier gelistet und internationale Referenzen sind hier zusammengefasst.
Maximale Kompatibilität: Unsere Software unterstützt sowohl klassische Mainframe-Plattformen (Fujitsu BS2000/OSD, IBM z/OS, z/VSE, z/Linux) als auch moderne Open-System-Umgebungen wie Linux, UNIX-Derivate und Windows.
Sparen Sie Zeit und Geld bei der Manipulation oder dem Schutz Ihrer Daten mit unserer bewährten Low-Code-Datenmanagement- und Maskierungssoftware. Wir verbinden modernste Technologie mit jahrzehntelanger Erfahrung in der Verarbeitung von Produktionsdaten auf verschiedenen Plattformen und in unterschiedlichen Branchen.
Mit unserer Software können Sie:
Große Sortier- und ETL-Aufträge beschleunigen
Beschleunigung von Datenbank-Entladungen, -Ladungen, -Reorgs und -Abfragen
Konvertieren und Neuformatieren von alten Datentypen, Dateien und Datenbanken
Erstellung benutzerdefinierter Berichte oder Aufbereitung von Daten für Analysen und KI
Ersetzen von alten ETL-, SQL- und Sortieraufträgen
Suchen, Extrahieren und Restrukturieren unstrukturierter Daten
Replizieren und Erfassen geänderter Datenbank-Daten in Echtzeit
Filtern, Bereinigen, Anreichern und Standardisieren von Daten
PII klassifizieren, entdecken und de-identifizieren
Daten statisch, dynamisch oder inkrementell maskieren
PHI-Re-ID-Risiko bewerten und Quasi-Identifikatoren anonymisieren
Synthetisieren von strukturell und referenziell korrekten Testdaten
Profitieren Sie von der Leistungsfähigkeit und Flexibilität der preisgekrönten IRI-Lösungen, die von Analysten beraten und durch 40 Partnerbüros weltweit unterstützt werden. Vermeiden Sie die steile Lernkurve und die hohen Kosten von Multi-Tool- und Mega-Anbieter-Lösungen und entdecken Sie die Vorteile schnellerer Design- und Laufzeiten für Ihr Unternehmen.
Die spezifischen Lösungen sind kompatibel mit allen gängigen Betriebssystemen, vom Mainframe (Fujitsu BS2000/OSD, IBM z/OS und z/VSE + z/Linux) bis hin zu Open Systems (UNIX & Derivate, Linux + Windows).
Seit 1978 weltweit anerkannt im B2B-Sektor: Großunternehmen, nationale und internationale Dienstleister, Privat-, Groß-, Landes- und Bundesbanken, Sozial- und Privatversicherungen sowie deutsche, Landes- und Bundesbehörden!
JET-Software
Edmund-Lang-Straße 16
64832 Babenhausen
Telefon: +49 (6073) 711-403
Telefax: +49 (6073) 711-405
https://www.jet-software.com
Telefon: +49 (6073) 711403
Fax: +49 (6073) 711405
E-Mail: amadeus.thomas@jet-software.com

❌ Patientendaten sicher schützen ❌ Datenmaskierung und Datenschutz im Gesundheitswesen ❗
Sensible Gesundheitsdaten, PII und PHI mit Datenmaskierung, Anonymisierung und sicheren Testdaten nachhaltig schützen.
Datenschutzverletzungen und steigende regulatorische Anforderungen stellen Krankenhäuser, Kliniken, Versicherungen, Forschungseinrichtungen und andere Organisationen im Gesundheitswesen vor große Herausforderungen. Besonders personenbezogene Daten (PII) und geschützte Gesundheitsinformationen (PHI) müssen zuverlässig vor unbefugtem Zugriff und Datenlecks geschützt werden.
Gleichzeitig müssen Patientendaten für Entwicklung, Tests, Analysen, Forschung und digitale Prozesse weiterhin nutzbar bleiben. Moderne Datenmaskierung, Pseudonymisierung, Anonymisierung und synthetische Testdaten ermöglichen es, Datenschutz und Datennutzung miteinander zu verbinden.
Patientendaten direkt an der Datenquelle schützen:
Klassische Sicherheitsmaßnahmen wie Firewalls, Zugriffskontrollen und Verschlüsselung bleiben wichtig. Sie schützen jedoch primär Systeme, Netzwerke oder Übertragungswege. Ein datenzentrierter Datenschutzansatz setzt zusätzlich direkt bei den sensiblen Informationen an.
Durch Datenmaskierung und Pseudonymisierung werden Patientendaten bereits dort geschützt, wo sie gespeichert oder verarbeitet werden. Selbst wenn Daten kopiert, exportiert oder unbeabsichtigt offengelegt werden, können maskierte Informationen für Unbefugte wertlos bleiben.
Dieser Ansatz eignet sich besonders für sensible Gesundheitsdaten in:
- relationalen Datenbanken
- Flat Files
- NoSQL-Datenbanken
- JSON und XML
- Dokumenten und PDFs
- medizinischen Bilddaten
- DICOM-Dateien
- HL7-Daten
- X12-EDI
- Logs und weiteren unstrukturierten Datenquellen
Datenmaskierung für PII und PHI im Gesundheitswesen:
Mit IRI Voracity lassen sich Datenmanagement, Datenschutz und Testdatenmanagement innerhalb einer zentralen Plattform verbinden.
Sensible Informationen können zunächst klassifiziert und gefunden und anschließend beispielsweise durch Maskierung, Pseudonymisierung, Verschlüsselung oder andere De-Identifizierungsmethoden geschützt werden.
Dabei können strukturierte, semi-strukturierte und unstrukturierte Datenquellen in gemeinsame Datenschutzprozesse eingebunden werden.
Gerade im Gesundheitswesen ist dies entscheidend, weil Patientendaten häufig nicht nur in klassischen Datenbanken liegen. PHI kann ebenso in Dokumenten, Freitexten, medizinischen Dateien oder Metadaten enthalten sein.
Sichere Testdaten ohne sensible Patientendaten:
Produktive Patientendaten sollten möglichst nicht ungeschützt in Entwicklungs-, Test- oder QA-Systemen verwendet werden.
IRI Voracity unterstützt verschiedene Ansätze zur Erstellung datenschutzkonformer Testdaten:
1. Maskierung von Produktionsdaten
Sensible personenbezogene und medizinische Informationen werden gezielt anonymisiert oder pseudonymisiert.
2. Data Subsetting mit Maskierung
Nur benötigte Teilmengen produktiver Daten werden übernommen und sensible Felder gleichzeitig geschützt.
3. Synthetische Testdaten
Künstliche, realistische Daten können erzeugt werden, ohne reale Patientendaten verwenden zu müssen.
4. Kombination verschiedener Methoden
Maskierung, Subsetting und synthetische Daten lassen sich abhängig vom jeweiligen Anwendungsfall kombinieren.
Referenzielle Beziehungen und Datenstrukturen können dabei erhalten bleiben, damit realistische Entwicklungs- und Testumgebungen entstehen.
Datenschutz für DICOM, HL7 und weitere Gesundheitsdaten:
Eine besondere Herausforderung bilden branchenspezifische Datenformate.
DICOM-Dateien können beispielsweise Patientennamen, IDs, Geburtsdaten und weitere PHI sowohl in Metadaten als auch innerhalb medizinischer Bilder enthalten.
Auch HL7-Daten können sensible Patientendaten in komplexen strukturierten und unstrukturierten Bereichen enthalten.
Moderne Data-Discovery- und Maskierungsverfahren helfen dabei, solche Informationen systematisch zu erkennen und gezielt zu schützen.
DSGVO, Compliance und Datenschutz gemeinsam umsetzen:
Die Kombination aus Datenerkennung, Klassifizierung, Datenmaskierung, Pseudonymisierung und sicheren Testdaten unterstützt Organisationen dabei, Datenschutzanforderungen wie die DSGVO sowie weitere branchenspezifische Compliance-Anforderungen umzusetzen.
Dabei geht es nicht nur darum, den Zugriff auf Daten zu kontrollieren. Entscheidend ist zunehmend, die sensiblen Daten selbst zu schützen.
So lassen sich Patientendaten weiterhin für notwendige Geschäfts-, Entwicklungs-, Forschungs- und Analyseprozesse verwenden, während personenbezogene und medizinische Informationen geschützt bleiben.
IRI Voracity für Datenschutz und Datenmanagement im Gesundheitswesen!
IRI Voracity verbindet Datenschutz mit weiteren Funktionen des Datenmanagements. Neben Datenmaskierung und Testdatenmanagement können beispielsweise ETL-Prozesse, Datenkonvertierung, Datenqualität, Datenmigration und die Vorbereitung von Daten für Analyse- und KI-Anwendungen integriert werden.
Die Plattform eignet sich für On-Premises-, Cloud- und hybride IT-Umgebungen und ermöglicht damit einen zentralen Ansatz für unterschiedliche Datenquellen und Datenplattformen.
Fazit: Patientendaten schützen, ohne ihre Nutzung zu verhindern!
Moderner Datenschutz im Gesundheitswesen bedeutet nicht, sensible Daten vollständig von Geschäfts- und Entwicklungsprozessen abzuschotten.
Durch Datenmaskierung, Pseudonymisierung, Anonymisierung und synthetische Testdaten können personenbezogene Daten und PHI geschützt und gleichzeitig für berechtigte Zwecke weiterhin nutzbar gemacht werden.
Ein datenzentrierter Ansatz mit IRI Voracity hilft dabei, Patientendaten direkt an der Quelle zu schützen, Datenschutzrisiken zu reduzieren und DSGVO-konforme Datenprozesse im Gesundheitswesen aufzubauen.
Effizienz trifft Erfahrung: Seit mehr als vier Jahrzehnten unterstützen unsere Softwarelösungen Unternehmen bei Datenmanagement und Datenschutz – technologisch führend, zuverlässig im produktiven Einsatz und branchenübergreifend einsetzbar.
Seit 1978 im Einsatz: Zahlreiche namhafte Unternehmen, Dienstleister, Finanzinstitute sowie Landes- und Bundesbehörden zählen zu unseren langjährigen Kunden – nationale Referenzen sind hier gelistet und internationale Referenzen sind hier zusammengefasst.
Maximale Kompatibilität: Unsere Software unterstützt sowohl klassische Mainframe-Plattformen (Fujitsu BS2000/OSD, IBM z/OS, z/VSE, z/Linux) als auch moderne Open-System-Umgebungen wie Linux, UNIX-Derivate und Windows.
Sparen Sie Zeit und Geld bei der Manipulation oder dem Schutz Ihrer Daten mit unserer bewährten Low-Code-Datenmanagement- und Maskierungssoftware. Wir verbinden modernste Technologie mit jahrzehntelanger Erfahrung in der Verarbeitung von Produktionsdaten auf verschiedenen Plattformen und in unterschiedlichen Branchen.
Mit unserer Software können Sie:
Große Sortier- und ETL-Aufträge beschleunigen
Beschleunigung von Datenbank-Entladungen, -Ladungen, -Reorgs und -Abfragen
Konvertieren und Neuformatieren von alten Datentypen, Dateien und Datenbanken
Erstellung benutzerdefinierter Berichte oder Aufbereitung von Daten für Analysen und KI
Ersetzen von alten ETL-, SQL- und Sortieraufträgen
Suchen, Extrahieren und Restrukturieren unstrukturierter Daten
Replizieren und Erfassen geänderter Datenbank-Daten in Echtzeit
Filtern, Bereinigen, Anreichern und Standardisieren von Daten
PII klassifizieren, entdecken und de-identifizieren
Daten statisch, dynamisch oder inkrementell maskieren
PHI-Re-ID-Risiko bewerten und Quasi-Identifikatoren anonymisieren
Synthetisieren von strukturell und referenziell korrekten Testdaten
Profitieren Sie von der Leistungsfähigkeit und Flexibilität der preisgekrönten IRI-Lösungen, die von Analysten beraten und durch 40 Partnerbüros weltweit unterstützt werden. Vermeiden Sie die steile Lernkurve und die hohen Kosten von Multi-Tool- und Mega-Anbieter-Lösungen und entdecken Sie die Vorteile schnellerer Design- und Laufzeiten für Ihr Unternehmen.
Die spezifischen Lösungen sind kompatibel mit allen gängigen Betriebssystemen, vom Mainframe (Fujitsu BS2000/OSD, IBM z/OS und z/VSE + z/Linux) bis hin zu Open Systems (UNIX & Derivate, Linux + Windows).
Seit 1978 weltweit anerkannt im B2B-Sektor: Großunternehmen, nationale und internationale Dienstleister, Privat-, Groß-, Landes- und Bundesbanken, Sozial- und Privatversicherungen sowie deutsche, Landes- und Bundesbehörden!
JET-Software
Edmund-Lang-Straße 16
64832 Babenhausen
Telefon: +49 (6073) 711-403
Telefax: +49 (6073) 711-405
https://www.jet-software.com
Telefon: +49 (6073) 711403
Fax: +49 (6073) 711405
E-Mail: amadeus.thomas@jet-software.com
